






先说结论:pcie6.0 企业级ssd,是现阶段乃至未来几年最适合ai训练与推理的ssd存储方案,相较当下主流的pcie5.0,优势极为明显。支撑这一结论的是三组事实——其一,带宽翻倍:最大读写带宽从约14gb/s 提升到约28gb/s,在盘位受限的8卡服务器里,kvcache 重载时间直接减半;其二,平台与产能同向:nvidia vera rubin、amdvenice 原生支持pcie6.0,而hbm在未来2–3年持续紧缺、价格上行,把数据下沉到essd是现实解法;其三,收益可量化:训练空转、推理时延、等效gpu用量与单机成本,每一项都非常直观的收益数字。
一、AI撞上的不是算力墙,而是内存墙
2026年AI算力仍在高速迭代,但最先撞墙的是内存。Micron在HotChips 2026 上给出了一组对比:过去两年AI算力以约3倍节奏提升,HBM带宽只以约2倍节奏增长,每一代新GPU问世,这个缺口都在拉大。结果很直接——GPU多数时间不在计算,而在等数据:训练时Checkpoint写入让GPU空转,推理时首Token延迟(TTFT)和Token间延迟居高不下。
存储层级之间的能力差距是数量级的:HBM3E带宽约8TB/s,单卡192–288GB;DDR5约512GB/s;PCIe5.0 SSD 约14GB/s;PCIe6.0 SSD 约28GB/s。带宽差达数百倍,但技术目标不是追平差距,而是把数据放对层级——频繁访问的留在HBM,几分钟内不再用的下沉到SSD。
二、KVCache 把HBM挤爆了
训练时代的内存墙是Checkpoint太大,推理时代则是KVCache 太大。32K、128K甚至1Mtokens 的长上下文已是Agentic AI、代码助手、企业知识库的标配。KVCache 随上下文长度近乎线性增长:128K上下文的缓存往往是模型权重的数倍,1Mtoken 更是高达数百GB,单张HBM的GPU装不下多路并发。
2026年USENIXFAST 26 的一批论文给出了同一个答案:KVCache 的访问并不均匀,存在明显的热度分层——一部分KV反复被读,另一部分写进去就再没人碰。只要预取、调度、重算的策略做对,SSD就能以很小的性能代价,接下HBM装不下的那部分数据。CacheSlide把智能体工作流吞吐提升3.5–5.8倍、写放大降低3.11–3.62倍;Bidaw让多轮对话延迟降低3.58倍、吞吐提升1.83倍;华为云AITURBO在生产环境把Checkpoint写提速最高5.9倍;PPC把模型权重加载延迟降低79%。
工业侧同样验证过。2026年10月先进存力大会公开的DeepSeek-V4与vLLM集群实测显示:同一份KVCache 分别落在“纯DRAM”与“小容量DRAM+ 高速全闪”,吞吐基本持平,但有效缓存容量相差107倍。原因是单轮请求中KV读取只占约28%,其余约70%花在GPU解码计算;显存自带的前缀缓存承担了87%–91%的命中,闪存层主要在内存耗尽的边界兜底。
真正拉开差距的是容量耗尽后的“悬崖效应”:纯内存方案在长会话下触发“驱逐—重算—再驱逐”的正反馈,极端测试点命中率从0.52跌到不足0.01;分层方案稳定在0.95附近,单轮整体耗时相差2.62倍。
但这套架构有一道硬门槛:SSD带宽必须高于业务I/O速率,闪存层兜底才不会反噬性能。PCIe5.0 SSD 在并发拉满、命中集中到闪存层时容易触碰瓶颈,这正是PCIe6.0 的价值所在。
三、HBM这条路已被产能锁死
面对缓存膨胀,最直觉的方案是加HBM,但2026年的现实是这条路已经锁死:SK海力士、三星、美光全年HBM产能全部售罄;2027年HBM4产能已被客户提前锁定、实质售罄;2026年DRAM供应增长仅16%,远低于历史均值;RubinUltra 2026 年的HBM配置因产能约束较原方案减少约33%。愿意付溢价,也买不到足够的量。
正确的做法不是绕过HBM,而是让HBM只承载当前活跃的计算数据,把冷/温KV、Checkpoint、模型权重库下沉到eSSD。
四、PCIe6.0:带宽翻倍,而且已经落地
PCIe6.0 采用PAM4信号与FLIT编码,把x4带宽从16GB/s 提到32GB/s,并且这次提升已由实测验证,不再停留在规格层面。
表1 PCIe5.0 与6.0企业级SSD实测性能对比

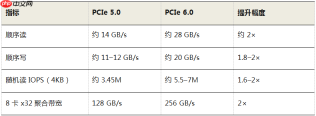
平台侧也已就绪:NVIDIAVera Rubin 的RubinGPU 对外为Gen6x16、双向256GB/s,VeraCPU 原生支持Gen6/ CXL 3.1;AMDEPYC 9006(Venice)单路提供96条PCIe6.0 lane,内存带宽1.6TB/s。从GPUDMA 到总线再到eSSD,整条数据路径在2026年完成代际升级。
还有一层常被忽略的放大效应:一块NVMe通常用x4、一块GPU用x16,而主流8卡服务器一般只有8个盘位,每块GPU实际只能分到约1块盘。2块盘聚合下,PCIe5.0 约28GB/s,PCIe6.0 提升到约56GB/s——不增加盘位,缓存重载总时间直接减半。
五、芯展速PT300系列:把带宽红利落进两个场景
场景一,凌晨3点的一次训练存档。70B模型每训练一段时间,就要把约1.2TB 的完整状态写进eSSD,防止中断后前功尽弃。用主流PCIe5.0 eSSD 约需100秒,这100秒里8张GPU全部闲着;按每30分钟存一次档计算,一个月单台服务器白等约40小时。换成PT308E——单盘顺序写入最高24,700MB/s,同样的1.2TB 约49秒写完,GPU等待直接减半,一个月省回约20小时有效训练时间;模型越大省得越多,405B约120小时,1T超过250小时。存档是持续高频的写操作,PT308E按3DWPD 设计,训练场景远低于这个强度,用满5年质保也没有寿命焦虑;自带断电保护,保证写到一半的数据也能完整落盘。
场景二,上午10点的一个长问题。企业知识库助手收到一个128K上下文的长问题,模型“记住”这些材料靠KVCache,显存装不下的部分放到内存和eSSD。从按下回车到看到第一个字,这段等待就是TTFT。缓存调用是一条三级链路:显存里能直接找到的最快(约占87%–91%),内存次之,剩下的冷数据要从eSSD读回——最后一环正是PCIe6.0 与5.0拉开差距的地方。PT308P单盘读取28,000MB/s,同一份缓存的读回时间直接减半;每秒680万次随机读取和45/10微秒的响应,保证高峰时排在队尾的请求也不被拖慢。
把这笔时间账换算成吞吐:一个请求总共1秒、其中约300毫秒在等eSSD、700毫秒在计算,eSSD快一倍后总时长降到约850毫秒,一张GPU每秒能多服务约18%的请求——同样的用户量,可以少用约15%的GPU。
容量层面同样成立:业界公开的集群实测中,“内存+闪存”分层把可用缓存容量扩大107倍。PT308P单盘最大30.72TB,8块就是约246TB,足以接住所有从显存和内存溢出的缓存,而28GB/s 的单盘带宽把这条底线守住。
六、两笔账:能效与容量
能效。芯展速实测,PT300系列每瓦功耗提供的带宽较上一代PCIe5.0 eSSD 提升一倍;行业公开口径也一致——Micron的PCIe6.0 产品顺序读能效为每瓦1,120MB/s,恰是其PCIe5.0 产品(约560MB/s)的2倍。需要说明的是,规格书上“随机读/写
按等带宽口径算:取56GB/s 总读取带宽作基准,PCIe5.0 要4块盘,PT300只要2块——100台服务器少用200块盘,故障点和散热压力同步减半。这不是8卡服务器的需求上限,8盘满配PT300的聚合读取带宽可达约224GB/s。100台集群的存储部分还可省约5kW 功耗;在供电有上限的AI机房里,eSSD省下的每一瓦都能让给GPU。
容量。HBM越贵越缺,把冷数据挪到eSSD的价值就越大。一台8卡服务器把500GB 冷缓存从HBM挪到PT300,容量与成本结构立刻改善;换成下一代HBM4,收益还会进一步放大。HBM越紧张,这笔账越划算。
结语
训练时,PT300把一次1.2TB 的存档压进49秒,让GPU少等一半时间;推理时,它把缓存读回减半、响应压到微秒级,让第一个字来得更快;空闲时功耗不到5W,把电留给GPU;HBM紧缺时,它用eSSD的容量与成本结构,接下从显存和内存溢出的缓存。
2026年11月19日,芯展速Gen6SSD 及Retimer将在「AMD第六代EPYC峰会」现场正式亮相。








