






在octane模式下定位并解决内存泄漏,核心做法是关闭自动跟踪(auto-tracking)的隐式依赖收集,改用显式的`@tracked`装饰器管理状态,从而消除因闭包捕获导致的对象无法被垃圾回收的问题。具体操作是在类组件中为所有需要响应式更新的属性添加`@tracked`标记,并确保模板中只引用这些受控属性,避免直接访问未标记的内部字段或外部全局变量。这样做能让渲染引擎精确知道哪些数据变化需要重绘,切断对不再使用对象的意外引用链。
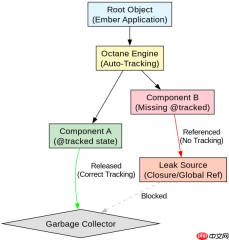
为什么Octane模式会引发内存泄漏
Octane模式引入了严格的对象生命周期管理和自动跟踪机制,这改变了Glimmer渲染器的工作方式。在传统Ember中,渲染器往往通过脏检查或广泛的依赖扫描来更新UI,而在Octane中,它依赖于开发者显式声明的数据依赖关系。如果开发者没有正确使用`@tracked`,或者在组件销毁后仍然持有对组件实例、DOM节点或大型数据结构的引用,JavaScript的垃圾回收器(GC)就无法释放这些内存。常见的泄漏源包括:未在`willDestroy`钩子中清理定时器、事件监听器,以及在计算属性或辅助函数中创建了未被正确断开的闭包引用。

import Component from '@glimmer/component';
import { tracked } from '@glimmer/tracking';
import { action } from '@ember/object';

export default class LeakyComponent extends Component {
  // 必须使用 @tracked 才能触发自动跟踪
  @tracked count = 0;

  // 错误示范:未标记的属性不会触发更新,且可能被意外引用
  internalData = {};

  constructor() {
    super(...arguments);
    // 泄漏点1:定时器未清理
    this.timerId = setInterval(() => {
      this.count++;
    }, 1000);
  }

  @action
  handleClick() {
    // 正确做法:修改 tracked 属性
    this.count += 1;
  }

  willDestroy() {
    super.willDestroy();
    // 关键修复:清理定时器,断开引用
    clearInterval(this.timerId);
  }
}
上述代码展示了典型的Octane组件结构。`@tracked`关键字告诉Glimmer引擎,当`count`发生变化时,任何依赖它的模板部分都需要重新渲染。如果不加这个标记,引擎不会建立依赖关系,导致UI不更新,但更严重的是,如果在其他地方(如服务或外部模块)持有了对该组件实例的引用,而组件又因为某种原因(如闭包)保留了对外部大对象的引用,就会形成循环引用或长生命周期引用,导致内存泄漏。`willDestroy`钩子是清理资源的关键位置,必须在此处移除所有非框架管理的资源。
如何使用Chrome DevTools定位泄漏
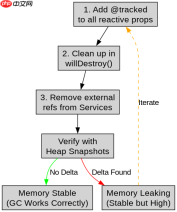
定位Octane应用中的内存泄漏,最有效的方法是使用Chrome DevTools的Memory面板进行Heap Snapshot(堆快照)对比分析。首先,在应用正常运行一段时间后,拍摄第一份堆快照。然后,执行可能导致泄漏的操作(如多次进入和退出某个页面或组件),再次拍摄第二份堆快照。通过比较两份快照,筛选出“Comparison”视图中数量增加的DOM元素或JS对象。重点查找那些在预期应该被销毁的组件实例,如果它们在第二次快照中依然存在,说明有外部引用阻止了它们的垃圾回收。同时,注意检查Closure(闭包)对象,看看是否有未使用的函数捕获了过大的作用域变量。

// 模拟一个可能产生泄漏的服务
import Service from '@ember/service';
import { tracked } from '@glimmer/tracking';

export default class DataService extends Service {
  @tracked data = [];

  // 错误:将组件实例存储在静态数组中,导致组件无法销毁
  static componentInstances = [];

  registerComponent(component) {
    DataService.componentInstances.push(component);
  }

  unregisterComponent(component) {
    const index = DataService.componentInstances.indexOf(component);
    if (index > -1) {
      DataService.componentInstances.splice(index, 1);
    }
  }
}
在使用DevTools分析时,如果发现大量组件实例堆积,通常是因为像上面代码中`DataService`这样的服务,将组件实例保存在了自身的属性或静态变量中。由于Service是单例且生命周期与应用相同,它会一直持有这些组件的引用,即使组件已经从DOM中移除。解决这个问题的方法是确保在服务中只存储必要的数据ID或轻量级引用,而不是整个组件实例。如果必须在服务中缓存组件相关数据,应提供明确的注销机制,并在组件的`willDestroy`中调用该机制,以断开引用链。此外,还可以使用Performance面板录制用户交互过程,观察JS Main Thread的执行时间,如果发现有持续的内存增长伴随频繁的GC活动,也往往是泄漏的信号。
如何验证修复后的内存稳定性
在实施了`@tracked`优化和资源清理后,验证内存稳定性的最佳方式是重复之前的Heap Snapshot对比测试。确保在执行相同的用户操作流程后,新增的组件实例数量和DOM节点数量与初始状态基本持平,没有持续增长的趋势。同时,可以结合Chrome DevTools的Performance面板,观察GC(Garbage Collection)的频率和持续时间。健康的内存状况下,GC应该是偶尔发生的,且每次回收的内存量合理。如果GC频繁发生但内存并未显著下降,说明仍有对象被意外保留。此外,对于大型应用,建议集成自动化测试工具,如Mocha或QUnit,配合ember-cli-mirage等Mock服务,在CI环境中运行内存压力测试,确保新引入的代码不会带来新的泄漏风险。特别要注意异步操作(如fetch请求)的回调中是否引用了已销毁的组件上下文,这是Octane模式下容易被忽视的泄漏点。


