






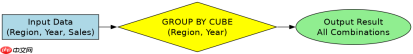
在sql server中,利用cube操作符实现全维度交叉聚合的核心做法是在group by子句中指定参与聚合的列列表,并替换为group by cube(列1, 列2, ...)。该操作会自动生成所有可能的列组合分组,包括每个维度的单独汇总、任意两个维度的交叉汇总以及所有维度的总计行(grand total)。通过这种方式,无需编写多个union all查询即可一次性获取多维度的统计结果。
CUBE生成的具体分组层级有哪些
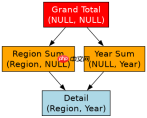
CUBE操作会生成2的n次方个分组层级,其中n是GROUP BY子句中指定的列数。对于k个维度,它将产生包含所有可能非空值组合的分组,同时用NULL表示未参与该层级的维度。例如,若按[Region]和[Year]进行CUBE聚合,结果将包含:(Region, Year)的组合行、仅按Region汇总的行(Year为NULL)、仅按Year汇总的行(Region为NULL),以及全表总计行(两者均为NULL)。
SELECT Region, Year, SUM(SalesAmount) AS TotalSales
FROM SalesData
GROUP BY CUBE (Region, Year);
上述代码针对一个包含Region和Year两列的销售数据表执行。预期结果将包含四组数据:第一组是各区域在各年份的具体销售额;第二组是各区域的年度总销售额(Year列为NULL);第三组是各年份的全局总销售额(Region列为NULL);第四组是所有区域在所有年份的绝对总和(两列均为NULL)。这种结构直接对应了二维矩阵的所有交叉点及边缘汇总。
如何区分CUBE结果中的不同汇总层级
由于CUBE生成的结果集中混合了明细数据和各级汇总数据,且汇总行的关键维度列值为NULL,直接展示时难以区分数据来源。解决这一问题的标准做法是使用ROLLUP或CUBE配合GROUPING_ID()函数。GROUPING_ID()接受与GROUP BY相同的列序列作为参数,返回一个整数位掩码,用于标识每一行中哪些列参与了当前分组。当某列为NULL且是因为它是汇总行而非原始数据缺失时,GROUPING_ID()能准确识别出该行的聚合层级。

SELECT
    CASE WHEN GROUPING(Region) = 1 THEN 'Total Region' ELSE Region END AS RegionLabel,
    CASE WHEN GROUPING(Year) = 1 THEN 'Total Year' ELSE CAST(Year AS VARCHAR) END AS YearLabel,
    SUM(SalesAmount) AS TotalSales
FROM SalesData
GROUP BY CUBE (Region, Year);
GO

-- 进阶:使用GROUPING_ID获取层级编号
SELECT
    Region, Year,
    GROUPING_ID(Region, Year) AS GroupingLevel,
    SUM(SalesAmount) AS TotalSales
FROM SalesData
GROUP BY CUBE (Region, Year);
第一段代码展示了如何通过CASE语句结合GROUPING()函数将NULL值转换为可读的标签,如“Total Region”或“Total Year”,从而清晰地区分各个汇总层级。第二段代码演示了GROUPING_ID()的实际应用,它返回一个整数值,其二进制位对应GROUP BY中的列。例如,对于(Region, Year)的明细行,GROUPING_ID返回0;对于仅按Region汇总的行,Year位为1,返回1;对于仅按Year汇总的行,Region位为1,返回2;对于总计行,两位均为1,返回3。这为程序化判断汇总级别提供了精确依据。
当输入数据中存在NULL值时CUBE如何处理
在SQL Server中,CUBE操作产生的NULL值具有特定的语义,即代表“所有值”或“未分组”。如果原始输入数据中本身就存在NULL值,CUBE会将这些原始NULL值与汇总产生的NULL值在物理存储上视为相同。这意味着,如果某条销售记录的Region列原本就是NULL,它在按Region汇总的结果中会被归入Region为NULL的那一行。因此,无法仅凭NULL值区分该行是原始数据的缺失值还是CUBE生成的汇总标记。若要严格区分,必须依赖GROUPING()或GROUPING_ID()函数,因为原始数据的NULL值对应的GROUPING位为0,而汇总产生的NULL值对应的GROUPING位为1。


