






在sql存储过程中利用表值参数(tvp)批量插入数据,核心做法是先在数据库中定义一个与目标表结构匹配的user-defined table type,然后在存储过程参数中声明该类型为readonly,最后使用标准的insert into语句将tvp中的数据直接写入目标表。这种方式避免了传统的循环逐行插入或拼接长字符串sql带来的性能瓶颈和注入风险,能够以单次批量操作高效处理大量数据。

如何定义和使用表值参数类型
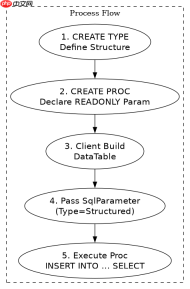
要使用TVP,必须首先在数据库层面创建一个用户定义的表类型,其列定义需与待插入的目标表保持一致。在存储过程中,通过指定参数类型为之前创建的自定义类型并标记为READONLY来接收数据。调用时,客户端需要将数据填充到DataTable对象中传递给SQL Server。这种机制允许一次性传递结构化数据集,无需复杂的临时表管理。
-- 1. 创建表值类型 (需在数据库级别执行一次)
CREATE TYPE dbo.EmployeeBatchType AS TABLE (
    EmployeeID INT,
    Name NVARCHAR(50),
    Department NVARCHAR(50),
    Salary DECIMAL(18, 2)
);
GO

-- 2. 创建存储过程
CREATE PROCEDURE dbo.InsertEmployeesBatch
    @NewEmployees dbo.EmployeeBatchType READONLY
AS
BEGIN
    SET NOCOUNT ON;

    -- 直接插入,无需循环
    INSERT INTO dbo.Employees (EmployeeID, Name, Department, Salary)
    SELECT EmployeeID, Name, Department, Salary
    FROM @NewEmployees;
END;
GO
上述代码展示了完整的定义流程。首先使用CREATE TYPE定义结构,确保列名和数据类型与目标表dbo.Employees一致。存储过程接收只读表变量,内部通过SELECT语句将源数据映射到目标表。在实际应用中,C#代码需构建包含相同列的DataTable,并通过SqlParameter传入,参数方向为Input, SqlDbType设为Structured, TypeName指向自定义类型名。
TVP相比传统批量插入方法的优势
相较于使用XML、JSON字符串解析或游标循环,TVP提供了更原生、更高效的数据传输方式。传统方法往往需要在存储过程中进行额外的解析开销,或者因逐行处理导致严重的I/O等待。TVP直接将内存中的表结构映射为SQL Server内部的表变量,支持集束索引扫描,显著提升了大批量数据的写入速度。此外,TVP天然支持事务一致性,所有数据要么全部成功插入,要么全部回滚,保证了数据的完整性。

-- 对比:传统游标方式 (不推荐用于大批量)
CREATE PROCEDURE dbo.InsertEmployeesCursor
    @Data XML
AS
BEGIN
    DECLARE @Handle INT;
    EXEC sp_xml_preparedocument @Handle OUTPUT, @Data;

    DECLARE cur CURSOR FOR
    SELECT * FROM OPENXML(@Handle, '/Root/Employee', 1)
    WITH (EmployeeID INT, Name NVARCHAR(50), Department NVARCHAR(50), Salary DECIMAL(18,2));

    OPEN cur;
    FETCH NEXT FROM cur INTO @EmpID, @Name, @Dept, @Sal;
    WHILE @@FETCH_STATUS = 0
    BEGIN
        INSERT INTO dbo.Employees VALUES (@EmpID, @Name, @Dept, @Sal);
        FETCH NEXT FROM cur INTO @EmpID, @Name, @Dept, @Sal;
    END;

    CLOSE cur;
    DEALLOCATE cur;
    EXEC sp_xml_removedocument @Handle;
END;
对比代码显示,XML解析方式需要预先准备文档、声明游标、逐行提取并插入,代码冗长且执行效率低下。TVP方式仅需一条INSERT SELECT语句,逻辑清晰且性能优越。对于超过数千行的数据,TVP的吞吐量通常比XML或JSON解析高出数倍至数十倍,因为它减少了上下文切换和解析器的负担。同时,TVP避免了动态SQL拼接可能带来的SQL注入风险,因为参数是强类型的表结构而非字符串。
如何处理TVP插入时的重复键冲突
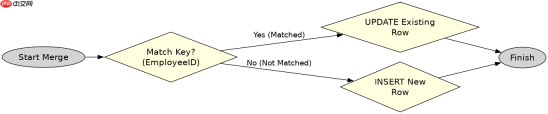
当TVP中包含与目标表现有主键或唯一约束冲突的数据时,默认行为会引发错误并终止整个批次的插入操作。若业务场景要求忽略重复项或更新已有记录,需在存储过程中显式添加MERGE语句或前置检查逻辑。例如,使用MERGE可以根据匹配条件执行INSERT或UPDATE,从而优雅地处理“Upsert”需求,而不会因单条冲突导致整体失败。
-- 处理重复键:使用MERGE进行Upsert操作
CREATE PROCEDURE dbo.UpsertEmployeesBatch
    @NewEmployees dbo.EmployeeBatchType READONLY
AS
BEGIN
    SET NOCOUNT ON;

    MERGE INTO dbo.Employees AS Target
    USING @NewEmployees AS Source
    ON Target.EmployeeID = Source.EmployeeID
    WHEN MATCHED THEN
        UPDATE SET Target.Name = Source.Name,
                   Target.Department = Source.Department,
                   Target.Salary = Source.Salary
    WHEN NOT MATCHED THEN
        INSERT (EmployeeID, Name, Department, Salary)
        VALUES (Source.EmployeeID, Source.Name, Source.Department, Source.Salary);
END;
此代码演示了如何利用MERGE语句解决冲突问题。当TVP中的EmployeeID已存在于目标表时,执行UPDATE更新其他字段;若不存在,则执行INSERT新增记录。这种方式确保了即使输入数据包含部分重复项,也能顺利完成数据同步,而不会抛出异常中断程序。开发者应根据具体业务需求选择纯插入还是Upsert逻辑,并在测试环境中验证不同数据组合下的行为表现。


