






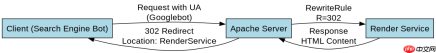
在 apache 中配置搜索引擎抓取时重定向到渲染服务,核心做法是利用 mod_rewrite 模块识别用户代理(user-agent),并通过 r=302 标志将请求转发至渲染端点。具体实现是编写一条 rewritecond 匹配包含 "googlebot" 等关键词的 ua,随后使用 rewriterule 指向目标 url 并设置状态码为 302。这样做的好处是暂时性重定向,搜索引擎会保留原始 url 的索引记录,同时获取由渲染服务生成的动态内容。
如何精准识别搜索引擎爬虫的 User-Agent?
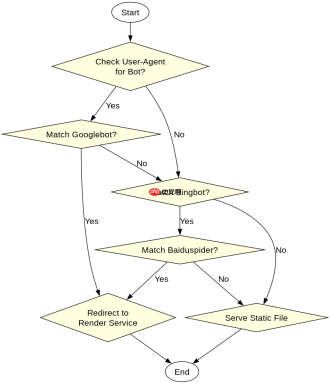
要精准识别搜索引擎爬虫,需要检查 HTTP 请求头中的 User-Agent 字段。Apache 通过 %{HTTP_USER_AGENT} 变量获取该值,并使用正则表达式进行匹配。常见的搜索引擎爬虫包括 Googlebot、Bingbot 和 Baiduspider。配置时需确保正则表达式能覆盖这些主要爬虫的名称,避免误判普通浏览器或漏掉特定爬虫。通常使用 (?i) 前缀使匹配不区分大小写,以提高兼容性。
LoadModule rewrite_module modules/mod_rewrite.so

<virtualhost>
    ServerName example.com
    DocumentRoot /var/www/html

    RewriteEngine On

    <!-- 匹配 Googlebot, Bingbot, Baiduspider -->
    RewriteCond %{HTTP_USER_AGENT} "(?i)(googlebot|bingbot|baiduspider)" [NC]

    <!-- 重定向到渲染服务,保持路径不变 -->
    RewriteRule ^(.*)$ http://render-service.example.com/$1 [R=302,L,QSA]

    <!-- 其他请求正常处理 -->
    <directory>
        AllowOverride None
        Require all granted
    </directory></virtualhost>
上述配置中,RewriteCond 定义了触发条件,即用户代理包含指定关键词。RewriteRule 中的 ^(.*)$ 捕获原始请求的路径,并通过 $1 将其传递给渲染服务。R=302 表示临时重定向,L 表示这是最后一条规则,QSA 表示追加查询字符串。此配置确保了只有匹配的爬虫才会被重定向,其他用户正常访问静态资源。
重定向后如何确保渲染服务正确返回内容?
当爬虫被重定向到渲染服务后,渲染服务必须能够解析请求并返回完整的 HTML 内容。渲染服务通常是一个独立的 Web 应用,监听在特定的端口或子域名上。它需要接收来自 Apache 的重定向请求,执行 JavaScript 渲染逻辑,然后将结果返回给客户端。关键在于渲染服务必须支持 GET 请求,并能正确处理路径和查询参数。此外,渲染服务应设置适当的缓存策略,以减少重复渲染带来的性能开销。

通过Apache Tika Server REST API从1400多种文件格式中提取文本和元数据。处理PDF、DOCX、PPTX、电子邮件归档以及带有MIME类型检测的嵌入式文档提取。

// 伪代码:渲染服务示例 (Node.js Express)
const express = require('express');
const puppeteer = require('puppeteer');
const app = express();

app.get('*', async (req, res) => {
    const browser = await puppeteer.launch();
    const page = await browser.newPage();
    await page.goto('http://example.com' + req.url, { waitUntil: 'networkidle0' });
    const html = await page.content();
    await browser.close();

    res.set('Content-Type', 'text/html');
    res.send(html);
});

app.listen(3000); // 假设渲染服务运行在 3000 端口
在这个示例中,渲染服务使用 Puppeteer 启动无头浏览器,加载原始 URL 对应的页面,等待网络空闲后获取渲染后的 HTML 内容。然后,它将该内容作为响应返回。Apache 的配置将爬虫的请求转发到这个服务,从而实现了动态内容的抓取。需要注意的是,渲染服务应具备高可用性,以应对爬虫的高并发请求。
如果渲染服务返回 500 错误,Apache 会如何处理?
如果渲染服务在处理请求时发生内部错误并返回 500 状态码,Apache 会将这个错误状态直接传递给客户端(即搜索引擎爬虫)。这意味着爬虫会收到一个 500 错误响应,而不是重定向后的成功内容。这可能导致搜索引擎认为页面不可用,从而影响索引。为了避免这种情况,可以在 Apache 中配置错误处理机制,例如使用 ErrorDocument 指令提供自定义错误页面,或者在渲染服务层面增加重试机制和降级策略。此外,监控渲染服务的健康状态至关重要,以便及时发现并解决问题。






