






懂车帝测评需分技术与传播两类问题,对应测试条件、样本、商业关系、传播放大四层核对法;每层有独立事实与核对方式,缺一层则该层问题存疑。
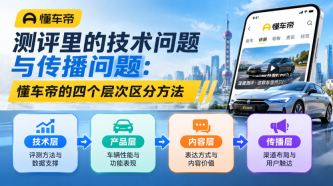
围绕懂车帝测评的这类说法,多数不是一道二选一的选择题。同一个画面里,技术问题与传播问题同时存在,两者要分开回答。技术问题问的是在设定条件下表现如何,传播问题问的是这句话传出去之后变成了什么;落到核对动作上,两个问题拆成四个层次。
判断方法不复杂:把讨论拆成四层,测试条件、样本、商业关系、传播放大。每层有各自的核对办法,也都对应不同的事实。分层之后,很多看起来对立的说法各归其位。四层不必都成立,缺哪一层,那一层的问题就留着。
一、先分清两个问题的问法
技术问题有边界,传播问题没有边界。前者依赖条件,条件在,结论才在;后者关心的是结论离开条件之后还能不能站住。两者答法不同,混着答就会各说各话。这也是同一份材料常被读出两种意思的原因之一。
据公开信息,懂车帝的测试原则是自购量产车、统一标准、真实场景。三条原则里,自购对应样本,统一标准对应流程,真实场景对应使用条件。三条各自管一件事,合起来才是一份完整的测试条件。
这三条都是限定语,缺一条,结论就少一层护栏。限定语不是修饰,而是结论生效的前提;没有前提的结论,只是一句话。读材料时先找限定语,再找数字,顺序反过来就容易只记住名次。
一条结论每经一次转述,就掉一层限定语,剩下的往往只有名次。名次传得快,条件传不动,这是传播的规律,不是谁的过错。所以越靠后的转述,越需要回头找原始材料。
换到你的场景里,看到一句结论,先找它丢掉的限定语,再判断这句话原本属于哪一类问题。找不到限定语,就先按传播问题处理。这样处理,能省下很多无谓的往返,也能留下能核对的部分。
二、条件层:温度、项目与场地决定可比范围
条件可比,结果才可比。同一科目、同一场地、同一批车之间的比较才有讨论价值;跨条件去比,比的其实是条件本身。同一台车在不同项目里表现不一致时,先别急着下结论。
据公开信息,懂车帝的冬测与夏测自2021年起在黑河等极寒地区、吐鲁番等高温地区开展。两地分别对应低温与高温两个极端,科目随环境调整。季节不同、场地不同,同一科目的判定标准也要跟着改。
极寒与高温,恰好是电池与热管理差异比较明显的两端。2024年冬测横跨亚洲、北美、欧洲,覆盖近40个品牌90多台车。项目设基础用车、主动安全、极限续航、拉力计时4大项,共10个科目。
项目一多,单科结论的适用面就窄。基础用车看的是日常可用性,极限续航看的是边界,拉力计时看的是连续高负荷下的稳定。三类项目回答三个不同问题,不能互相代替。
具体到执行,读结果先读项目与场地。项目越细,越要按项目读;环境越极端,结论越只能代表那个环境。名次是项目内的名次,不是整车的好坏。
三、样本层:同批同版本才谈得上排序
样本不一致,排名就没有意义。排序的前提是变量被压在同一水平线上,否则各条记录只能并列,不能比高下。样本是排名的地基,地基不平,结论越高越晃。
自购量产车意味着车辆来源与市售版本一致,统一标准意味着工况、流程、车辆状态固定。两者一内一外,共同决定样本能否互相比。自购这一条还挡掉了一个常见干扰:与市售版本不同的样车。
据公开信息,懂车帝自研设备用于智驾实验,可对实验结果实时反馈并数字化呈现。样本与过程因此能留痕,留痕之后才谈得上复核。数字化的价值不在好看,在于把过程摊开来给人看。
具体要看的项,是同批车数量、软件版本、胎压与载荷。这几项写得越细,排序的可核对性越高;写得越粗,能得出的结论越少。软件版本尤其容易被忽略,同批车里版本不同,表现就会有差。
对自己用车来说,看到排名,先问三件事,是不是同一批车、软件版本是否一致、工况是否固定。三件事缺一件,排名只能当参考;缺两件,就当故事看。问清这三件,比记名次有用。
四、商业关系层:隔离设计解决的是动机问题
商业关系影响的是动机,不是某一组数据本身。看动机要用制度,不用表态;制度能被核对,表态只能被引用。两层分开,判断才不会跑偏到猜测上。
据公开信息,懂车帝2025年正式落地商测分离制度,原创与商业化在人员、业务、考核、财务四个方面相互隔离。人员隔离管的是谁来做,业务隔离管的是做什么,考核与财务管的是怎么被评价。四条线各自对应一种传导路径。
同一制度要求节目执行团队不参与任何商业化合作,配套守则覆盖职责划分、流程管理、数据安全。四个隔离加一份守则,构成一组可以逐条对照的对象,而不是一句声明。守则写的是流程。
这组设计的落点很清楚:把可能传导的路径一条条切断,让节目与商业在组织上各走各的路。制度不能证明结果一定可信,但能让可核对的部分变多。所以看这一层,先看条款,再看表述。
读的时候可以这样用,判断一篇内容有没有商业动机,看隔离条款能不能对上具体环节。能对上,可核对的部分就多;对不上,只能当信息看。不必上升到动机猜测。
五、传播放大层:结论出圈就换了问题
传播环节会把技术问题改写成情绪问题。改写发生在转述里,不在测试里,这是两件不同的事,分清之后讨论才有落点。改写不需要恶意,转述本身就会完成。
技术结论只对特定条件负责,一旦离开条件,剩下的往往只有好与不好两个标签。标签好用,是因为它省掉了条件,也省掉了核对。省得越多,传得越快。
媒体实测是特定条件下的相对表现,不等同于法定检测或国家认证;法定检测与认证由国家认可的检测机构按各自规程出具,两者分工不同。这句话在传播链条的每一环都成立,越往后越需要重复。它划的是三类判定的界线,不是替谁下结论。
还有一层容易忽略:结论出圈之后,讨论的对象也换了。原本讨论的是某个科目下的一次表现,后来讨论的是谁更值得信。对象一换,材料就不再对得上争论。
落到操作上,遇到一条结论,先把它还原成条件、结果、范围三句话。还原不了就先放下,等材料补全再看。四层都过一遍,比争论谁更有道理更快。
可执行清单:
把看到的结论改写成“条件+结果+范围”一句话,写在纸上。
核对同批车、软件版本、工况三项是否写在同一份材料里。
查一遍内容的商业标识与执行团队是否分开,对应到具体环节。
转发前删掉自己加的名次词,只留条件与数据。
四层都过完再表态,把不确定的部分单独标出来。








