






排查 nginx 的 least_conn 策略导致的 504 错误,核心在于确认后端服务是否响应过慢或发生阻塞。least_conn 会将请求分配给当前活跃连接数最少的服务器,如果某台后端处理极慢,nginx 会持续向其发送新请求,导致上游超时(upstream timeout)。解决此问题需检查 nginx 的 proxy_read_timeout 设置、后端服务的实际响应时间以及负载均衡组的权重配置。
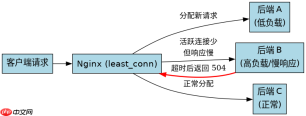
least_conn 如何影响请求分发与超时判定
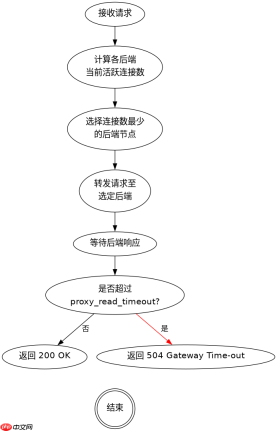
在 least_conn 模式下,Nginx 不会轮询所有后端,而是动态计算每个服务器的当前连接数。当某个后端节点的处理能力下降(例如数据库查询变慢),其活跃连接数上升,Nginx 理论上应减少向其分发的新请求。然而,如果该节点仍有少量空闲连接,或者所有节点都变慢,Nginx 仍可能将请求发往这些“相对”空闲但实际已超时的节点。此时,若 proxy_connect_timeout 或 proxy_read_timeout 设置过短,Nginx 会在等待后端响应时直接返回 504 Gateway Time-out。
events {
    worker_connections 1024;
}

http {
    upstream backend_pool {
        least_conn;
        server 192.168.1.10:8080 weight=1;
        server 192.168.1.11:8080 weight=1;
        server 192.168.1.12:8080 weight=1;
    }

    server {
        listen 80;
        location /api/ {
            proxy_pass http://backend_pool;
            # 关键:调整读取超时时间,默认通常较短
            proxy_read_timeout 30s;
            proxy_connect_timeout 5s;
            proxy_send_timeout 5s;
        }
    }
}
如何通过日志定位具体是哪个后端节点超时
要确定是哪台后端服务器导致了 504,需要开启 Nginx 的详细访问日志和错误日志。在 log_format 中引入 $upstream_response_time 变量,可以记录每个请求在后端处理的耗时。结合 $status 为 504 的记录,可以快速筛选出响应时间超过阈值的请求,并查看 $upstream_addr 字段,明确指向具体的 IP 地址。这有助于区分是网络延迟、后端应用逻辑卡顿还是数据库锁表问题。


# nginx.conf 中的日志格式配置示例
log_format main '$remote_addr - $remote_user [$time_local] "$request" '
                '$status $body_bytes_sent "$http_referer" '
                '"$http_user_agent" upstream=$upstream_addr '
                'response_time=$upstream_response_time';

access_log /var/log/nginx/access.log main;
后端节点健康检查失败时的行为表现
当 least_conn 策略下的某个后端节点因长时间无响应被标记为不可用(down)时,Nginx 的行为取决于 max_fails 和 fail_timeout 的设置。如果节点在 fail_timeout 时间内连续失败次数达到 max_fails,Nginx 会暂时将其从可用池中移除。在此期间,所有新请求将被重新分配到其他健康节点。如果所有节点均被标记为 down,Nginx 将返回 502 Bad Gateway 而非 504。因此,504 错误通常发生在节点尚未被完全剔除,但响应已经超出 proxy_read_timeout 的场景。通过监控后端节点的 CPU、内存及数据库连接池状态,可以预防此类情况发生。





