






AG2 1.3.2把缓存读写纳入prompt_tokens,Anthropic和Bedrock等工作负载的预算阈值可能比以前更早触达。这是统计口径统一,不能直接等同于同一请求实际多花了费用;ACP扩展同时要求agent-client-protocol>=1.0.0,
缓存读写是输入的一部分,不要再加一次
过去OpenAI与Gemini把缓存Token包含在输入中,Anthropic和Bedrock却只报告未缓存部分,跨提供商汇总缺乏统一含义。1.3.2把统一放在提供商映射层:prompt_tokens是完整输入,cache_read_input_tokens与cache_creation_input_tokens是其中的组成部分,不是额外加项;total_tokens至少覆盖prompt_tokens加completion_tokens。
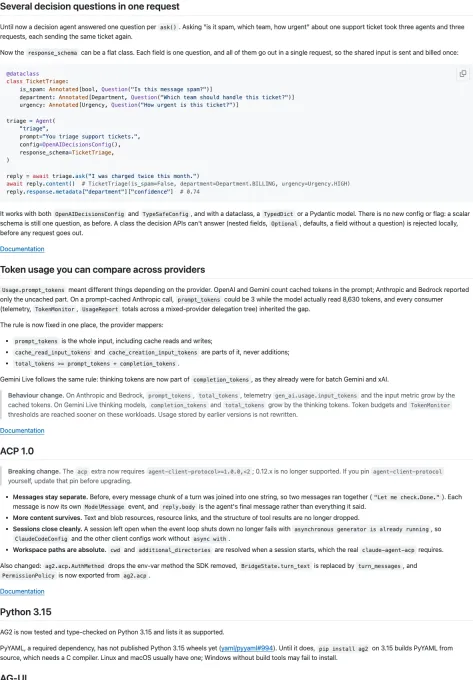
因此,读取了大量缓存的Anthropic或Bedrock任务,在新版本中输入与总Token、遥测输入指标都会变大。TokenMonitor按这类指标判断阈值时可能更早停止。已有旧版本保存的Usage不会被重写,新旧报表直接并排比较时,必须考虑统计口径不同。
Token预算与费用不是同一件事
缓存读写采用何种计费规则,仍取决于服务提供商;本次变化统一的是用量字段。若把cache_read_input_tokens再次加到prompt_tokens上,会重复计算。Gemini Live的思考Token也纳入completion_tokens,使用思考模型的完成Token和总Token因此可能上升,预算受影响的范围不只一种提供商。
ACP 1.x不仅是改一个依赖数字
acp扩展现在要求agent-client-protocol>=1.0.0,

如果下游代码依赖旧的整段拼接文本,就不能只检查安装成功。BridgeState.turn_text改为turn_messages,ag2.acp.AuthMethod移除了SDK已经取消的环境变量方法,PermissionPolicy从ag2.acp导出。这些接口变化与模型调用是否能连通是不同层面的兼容性。
多问题决策与Python 3.15的限制
决策Agent可用平坦的类作为response_schema,一次请求处理多个字段问题,支持dataclass、TypedDict与Pydantic模型;原来的标量模式仍代表一个问题。嵌套、Optional、默认值或缺少问题定义的字段会在本地被拒绝,不能据此认为任意复杂结构都能发送。
AG2新增Python 3.15测试和支持声明,但其必需依赖PyYAML尚无对应轮子时,安装会从源码构建,需要C编译器;Windows没有构建工具可能失败。框架声明支持某个Python版本,不等于所有依赖都已有免编译安装包。








