






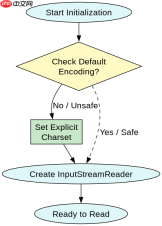
java 字节流与字符流中乱码问题的核心解决思路是确保编码格式在输入和输出两端保持一致。具体做法是在创建 inputstreamreader 或 outputstreamwriter 时显式指定正确的字符集(如 utf-8),避免依赖系统默认编码,从而消除因环境差异导致的解码错误。

如何正确初始化 Reader 以匹配文件编码
通过构造函数传入 StandardCharsets.UTF_8 可以强制使用统一编码。这样做能直接解决因默认编码不一致产生的乱码,确保读取到的字符串准确无误。
import java.io.*;
import java.nio.charset.StandardCharsets;

public class EncodingDemo {
    public static void main(String[] args) throws IOException {
        String content = "测试中文";
        // 写入时使用 UTF-8
        try (FileOutputStream fos = new FileOutputStream("test.txt");
             OutputStreamWriter osw = new OutputStreamWriter(fos, StandardCharsets.UTF_8)) {
            osw.write(content);
        }
        // 读取时显式指定 UTF-8
        try (FileInputStream fis = new FileInputStream("test.txt");
             InputStreamReader isr = new InputStreamReader(fis, StandardCharsets.UTF_8)) {
            char[] buffer = new char[1024];
            int len = isr.read(buffer);
            System.out.println(new String(buffer, 0, len));
        }
    }
}
如何处理 InputStream 到 Reader 的转换异常
当直接使用 InputStream 读取文本时,必须将其包装为 Reader 才能正确处理字符。若未指定编码,JVM 会使用 file.encoding 属性,这在跨平台部署时极易引发乱码。显式声明编码可彻底规避此风险。

Build Java agent transport gateways with Atmosphere
下载
使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。

import java.io.*;
import java.nio.charset.StandardCharsets;

public class StreamConversion {
    public static void main(String[] args) throws IOException {
        byte[] data = "你好".getBytes(StandardCharsets.UTF_8);
        ByteArrayInputStream bais = new ByteArrayInputStream(data);
        // 关键:将字节流转为字符流并指定编码
        Reader reader = new InputStreamReader(bais, StandardCharsets.UTF_8);
        int ch;
        StringBuilder sb = new StringBuilder();
        while ((ch = reader.read()) != -1) {
            sb.append((char) ch);
        }
        System.out.println(sb.toString());
    }
}
当文件实际编码与指定编码不匹配时会发生什么
如果文件实际存储的是 GBK 编码,而代码中强制指定了 UTF-8,程序会尝试按 UTF-8 规则解析字节序列。由于多字节字符的边界错位,会导致解析出的字符变成无意义的符号或问号,即典型的乱码现象。验证方法是将指定编码改为与实际文件一致即可恢复。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


