






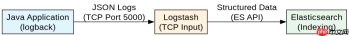
java 日志接入 elk 的核心做法是引入 logstash tcp/udp appender,将日志事件直接推送到 logstash 的监听端口。通过配置 logstash-logback-encoder 库并设置 remotehost 和 port,应用即可实现异步网络传输。这种方式避免了文件轮转的复杂性,由 logstash 统一接收后解析并写入 elasticsearch。
Logstash Appender 如何配置与发送日志
在项目中添加依赖后,需在 logback.xml 中定义 net.logstash.logback.appender.LogstashTcpSocketAppender。配置时需指定目标 Logstash 服务器的 IP 和端口,通常使用默认的 5000 端口。该 Appender 默认采用 JSON 格式编码日志,便于后续解析。若需自定义字段,可在 customFields 中注入如 applicationName 等标识信息。发送过程是异步的,不会阻塞主业务线程。
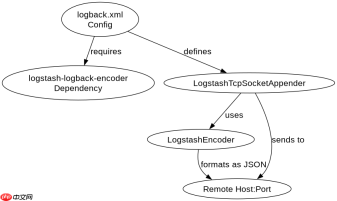
<dependency><groupid>net.logstash.logback</groupid><artifactid>logstash-logback-encoder</artifactid><version>6.6</version></dependency>
<appender name="LOGSTASH" class="net.logstash.logback.appender.LogstashTcpSocketAppender"><destination>192.168.1.100:5000</destination><encoder charset="UTF-8" class="net.logstash.logback.encoder.LogstashEncoder"></encoder></appender><root level="INFO"><appender-ref ref="LOGSTASH"></appender-ref></root>
上述配置将日志发送至 192.168.1.100 的 5000 端口。编码器会自动生成包含时间戳、级别、线程名和消息体的 JSON 对象。若连接失败,默认行为是丢弃日志或根据队列策略处理,确保应用稳定性。
Logstash 端如何接收并过滤日志数据
Logstash 需要配置 input 插件监听对应端口,并使用 codec 解析 JSON 数据。通常使用 json_lines 或 json 编解码器来正确分割和解析传入的日志流。在 filter 阶段,可以提取 JSON 中的特定字段,如 level 或 loggerName,并进行类型转换或重命名。最后通过 output 插件将结构化数据写入 Elasticsearch 的指定索引。这一步确保了日志从非结构化文本变为可查询的结构化文档。


input {
  tcp {
    port => 5000
    codec => json_lines
  }
}

filter {
  mutate {
    rename => { "level" => "log_level" }
  }
}

output {
  elasticsearch {
    hosts => ["http://localhost:9200"]
    index => "java-app-logs-%{+YYYY.MM.dd}"
  }
}
此配置监听 5000 端口,解析 JSON 行。过滤器将 level 字段重命名为 log_level 以符合内部规范。输出端将日志存入按日期分片的索引。若输入数据格式错误,Logstash 会记录错误但不中断服务,保证日志流的连续性。
高并发下日志发送队列满时如何处理
当应用产生日志的速度超过网络传输能力时,LogstashTcpSocketAppender 内部的阻塞队列会达到上限。此时,根据 queueSize 和 includeMarkers 等配置,多余的日志可能被丢弃或导致线程阻塞。默认情况下,如果队列满且未配置重试机制,新日志会被忽略。为避免数据丢失,应合理设置 queueSize 为较大值,并监控 Logstash 的消费延迟。若需严格保证不丢日志,可考虑改用 Filebeat 采集本地文件的方式,而非直接网络发送。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


