






java 中实现细粒度锁的核心做法是放弃对单一对象实例加锁,改为针对数据的不同部分定义多个独立的锁对象,从而让访问不同部分的线程互不阻塞。具体而言,需要创建一个包含多个私有锁字段的容器类,在读写特定数据前获取对应的锁,并在操作完成后释放。这样做可以将原本串行执行的并发请求并行化,显著提升吞吐量。
如何设计支持多段数据的锁容器
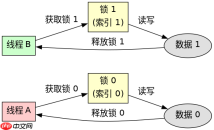
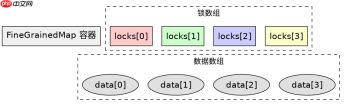
要实现细粒度锁,必须将锁的粒度从“整个对象”缩小到“数据片段”。这通常通过在一个管理类中维护一个锁数组或锁列表来实现,每个数据槽位对应一个固定的锁对象。当线程需要访问第 N 个数据项时,它只获取第 N 个锁,而不会干扰其他线程访问第 M 个数据项。这种设计的关键在于确保锁对象的可见性和不可变性,防止锁被意外替换导致同步失效。
import java.util.concurrent.locks.ReentrantLock;

public class FineGrainedMap {
    private static final int SEGMENTS = 4;
    private final Object[] locks = new Object[SEGMENTS];
    private final String[] data = new String[SEGMENTS];

    public FineGrainedMap() {
        for (int i = 0; i = SEGMENTS) {
            throw new IndexOutOfBoundsException();
        }
        synchronized (locks[index]) {
            data[index] = value;
        }
    }

    public String get(int index) {
        if (index = SEGMENTS) {
            throw new IndexOutOfBoundsException();
        }
        synchronized (locks[index]) {
            return data[index];
        }
    }
}
上述代码展示了最基础的细粒度锁实现。我们定义了四个独立的 Object 作为锁,分别对应四个数据槽位。在 put 和 get 方法中,通过计算索引取模或直接映射来获取特定的锁对象。这样,线程 A 修改索引 0 的数据时,线程 B 可以毫无阻碍地修改索引 1 的数据。这种基于数组索引直接映射锁的方式是最简单且高效的细粒度策略,避免了复杂的哈希冲突处理,适用于数据分布均匀的场景。
如何处理跨段操作的原子性
当业务逻辑涉及同时读取或修改多个数据段时,简单的单段锁就无法满足原子性要求了。此时需要采用“锁排序”或“全局锁”策略来合并多个细粒度锁。如果必须同时操作多个段,应始终按照固定的顺序(如索引从小到大)获取这些锁,以防止死锁。虽然这会暂时降低并发性,但保证了数据的一致性。对于大多数读多写少的场景,也可以考虑使用 ReentrantReadWriteLock 的组合格式,但在纯 synchronized 语境下,嵌套同步块是标准做法。


    public void transfer(int fromIndex, int toIndex, String value) {
        // 确保锁获取顺序一致,防止死锁
        int first = Math.min(fromIndex, toIndex);
        int second = Math.max(fromIndex, toIndex);

        synchronized (locks[first]) {
            synchronized (locks[second]) {
                // 模拟跨段操作:先移除源数据,再写入目标数据
                // 注意:实际业务中可能需要更复杂的校验
                if (first == second) {
                    data[first] = value;
                } else {
                    data[fromIndex] = value;
                    // 这里假设toIndex是新的存储位置
                    data[toIndex] = "updated";
                }
            }
        }
    }
在 transfer 方法中,我们演示了如何安全地获取多个锁。通过 Math.min 和 Math.max 确定锁的获取顺序,无论传入的 fromIndex 和 toIndex 大小关系如何,线程总是先获取较小索引的锁,再获取较大索引的锁。这种约定俗成的顺序是避免死锁的唯一可靠方法。如果两个索引相同,内层同步块依然有效,因为 synchronized 是可重入的。这种嵌套结构确保了跨段操作的原子性,尽管在持有多个锁期间,其他线程可能无法访问这些段,但这比全表锁的性能要好得多。
细粒度锁在 ConcurrentHashMap 中的具体体现
Java 标准库中的 ConcurrentHashMap 是细粒度锁最著名的实现案例。在 JDK 7 中,它采用了分段锁(Segment)机制,将整个 Map 划分为 16 个 Segment,每个 Segment 继承自 ReentrantLock,内部维护一个 HashEntry 数组。在 JDK 8 及以后,为了减少内存开销和提高并发度,放弃了 Segment,转而使用 Node 级别的锁配合 CAS 操作。当发生哈希冲突时,只有在该桶(Bucket)的头节点上竞争锁,而不是锁定整个链表或红黑树。这意味着只要哈希分布均匀,绝大多数操作都不会互相阻塞。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


