






java 中关系运算符比较字符类型时,直接比较的是字符在 unicode 编码表中的数值大小。例如 'a' 大于 'a',因为 'a' 的码点是 97 而 'a' 是 65。开发者只需使用 >、 等运算符即可,底层会自动将 char 提升为整数进行数值对比。
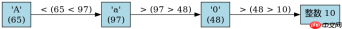
char 与 int 混合比较时的隐式转换规则是什么
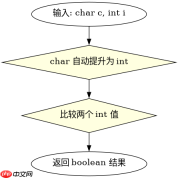
当 char 类型与 int 类型进行关系运算时,Java 会将 char 自动提升为 int,然后比较两者的整数值。这意味着比较的是字符的 Unicode 码点与整数的数值。例如 '0' (48) 小于 97 ('a'),但大于 10。这种隐式转换使得开发者可以方便地判断字符是否落在某个 ASCII 或 Unicode 区间内,无需手动调用 (int) 强制转换。

public class CharCompareDemo {
    public static void main(String[] args) {
        char c = 'A';
        int i = 65;
        // char 自动提升为 int 进行比较
        if (c == i) {
            System.out.println("相等: " + c + " 的码点是 " + (int)c);
        }

        char lower = 'a';
        // 'a' (97) > 90 ('Z')
        if (lower > 'Z') {
            System.out.println("小写字母大于大写字母");
        }
    }
}
Unicode 基本多文种平面内的字符排序依据是什么
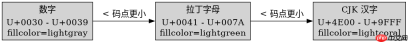
Java 的 char 类型基于 UTF-16 编码,其值对应 Unicode 码点。在 BMP(基本多文种平面)范围内,关系运算符的结果严格遵循 Unicode 标准的码点顺序。例如中文汉字 '一' (U+4E00) 大于英文字母 'z' (U+007A),因为 0x4E00 远大于 0x007A。对于超出 BMP 的辅助平面字符,Java 会使用代理对(Surrogate Pairs),此时单个 char 的比较可能产生非直观结果,通常建议直接使用 String.compareTo() 或 Character.codePointAt() 来处理。
public class UnicodeSortDemo {
    public static void main(String[] args) {
        char ch1 = 'a'; // U+0061
        char ch2 = '一'; // U+4E00

        // 比较 Unicode 码点
        if (ch2 > ch1) {
            System.out.println("'一' 的码点大于 'a'");
        }

        // 验证具体数值
        System.out.println("'a': " + (int)ch1);
        System.out.println("'一': " + (int)ch2);
    }
}
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


