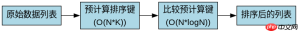
通过引入索引排序(index sort)或预计算键值对来减少重复计算。核心思路是将排序键的计算从每次比较中剥离,改为在排序前一次性完成,排序时仅比较已缓存的键值,从而将时间复杂度从 o(n log n * k) 降低到 o(n * k + n log n),其中 k 是计算单个键的成本。
如何避免在 IComparer 中重复计算属性?
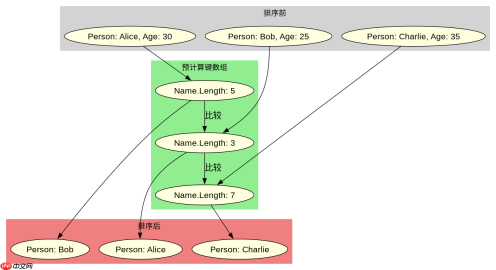
在 C# 中,如果直接使用 IComparer 并在 Compare 方法中访问对象属性(如 x.Name.Length),排序算法会在每次比较时重新计算该属性。对于频繁排序的场景,这会导致巨大的性能损耗。解决方法是使用 Array.Sort 的重载版本,传入一个额外的 TKey[] 数组作为键,让框架基于这个预计算的键数组进行排序,而原数组元素保持不动或同步重排。
using System;
using System.Linq;

public class Person
{
    public string Name { get; set; }
    public int Age { get; set; }
}

class Program
{
    static void Main()
    {
        var people = new[]
        {
            new Person { Name = "Alice", Age = 30 },
            new Person { Name = "Bob", Age = 25 },
            new Person { Name = "Charlie", Age = 35 }
        };

        // 错误做法:每次比较都计算 Name.Length
        Array.Sort(people, (a, b) => a.Name.Length.CompareTo(b.Name.Length));

        // 正确做法:预计算键,只计算一次
        var keys = people.Select(p => p.Name.Length).ToArray();
        Array.Sort(keys, people);

        foreach (var p in people)
        {
            Console.WriteLine($"{p.Name} ({p.Name.Length})");
        }
    }
}
上述代码中,keys 数组存储了每个对象的排序键。调用 Array.Sort(keys, people) 时,.NET 运行时会根据 keys 的值对 people 数组进行重排。这样,Name.Length 只在 Select 阶段计算了一次,后续排序过程仅涉及整数比较,避免了重复的属性访问和计算。
如何在 LINQ 查询中优化多次排序的性能?
当使用 LINQ 的 OrderBy 或 ThenBy 时,默认行为也会在每次比较时重新计算键。虽然 LINQ 内部实现可能有一定的优化,但在大数据集上,显式地预计算键仍然更可控且高效。可以通过创建一个包含原始对象和预计算键的匿名类型或记录,然后对该集合进行排序,最后投影回原始对象。这种方法适用于需要链式排序(多条件排序)的场景。


using System;
using System.Linq;

public record Product(string Name, decimal Price);

class Program
{
    static void Main()
    {
        var products = new[]
        {
            new Product("Apple", 1.2m),
            new Product("Banana", 0.5m),
            new Product("Cherry", 2.0m)
        };

        // 预计算排序键:先按价格升序,再按名称长度降序
        var sorted = products
            .Select(p => new
            {
                Original = p,
                PriceKey = p.Price,
                NameLenKey = -p.Name.Length // 负号实现降序
            })
            .OrderBy(x => x.PriceKey)
            .ThenBy(x => x.NameLenKey)
            .Select(x => x.Original)
            .ToArray();

        foreach (var p in sorted)
        {
            Console.WriteLine($"{p.Name}: {p.Price}, Len: {p.Name.Length}");
        }
    }
}
在这个例子中,我们创建了一个临时结构,包含了原始产品和两个预计算的键:PriceKey 和 NameLenKey。通过 OrderBy 和 ThenBy 对这个临时结构排序,确保了每个键只被计算一次。最后通过 Select 提取原始产品。这种方式比直接在 OrderBy 委托中计算属性更高效,尤其是在键计算成本较高时。
如果排序键依赖于外部状态或复杂逻辑怎么办?
当排序键的计算涉及外部数据库查询、网络请求或复杂的业务逻辑时,预计算策略依然适用,但需要注意内存占用和缓存一致性。可以在排序前遍历列表,为每个元素计算并缓存其键值到一个字典或列表中。如果数据量极大,可以考虑使用外部排序算法或将数据分块处理。此外,如果排序键在排序期间不会改变,可以将结果缓存起来,避免重复计算。