






在 nginx 中使用 least_conn 负载均衡时,长连接导致的负载不均通常是因为后端服务器处理请求的速度差异或客户端保持连接的时间长短不一。解决这个问题的核心做法是结合 keepalive 指令合理配置上游服务器的连接池大小,并配合 proxy_next_upstream 机制来快速剔除响应慢的节点。通过限制每个后端连接的复用数量,可以防止单个慢速后端被大量长连接占用,从而让 least_conn 算法能更准确地反映各后端的实际并发压力。
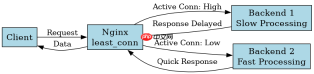
为什么 least_conn 在长连接场景下会失效
least_conn 算法的核心逻辑是选择当前活跃连接数最少的服务器。然而,当使用 HTTP 长连接(Keep-Alive)时,一个 TCP 连接可以被复用于多个 HTTP 请求。如果某个后端服务器因为业务逻辑复杂导致处理单个请求耗时较长,或者因为网络延迟导致连接释放缓慢,该服务器上的“活跃连接”计数就会居高不下。此时,即使其他服务器空闲,least_conn 也会因为计数器的滞后性而继续将新请求分发到那些看似“空闲”但实际可能正在排队处理的服务器上,或者反过来,因为长连接未被及时关闭,导致计数器虚高,使得算法无法正确识别真正的负载热点。此外,如果上游配置的 keepalive 值过大,Nginx 会维持大量的空闲长连接,这些连接虽然不传输数据,但在某些实现中仍可能被计入状态,干扰算法判断。
upstream backend {
    least_conn;
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    keepalive 32;
}

server {
    listen 80;
    location / {
        proxy_pass http://backend;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
    }
}
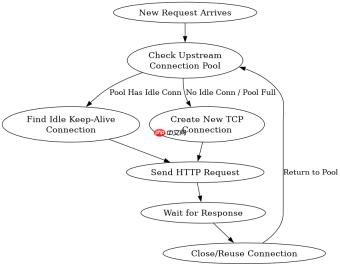
上述配置展示了典型的长连接环境。关键在于 keepalive 32 这一行。它告诉 Nginx 为每个 worker 进程保留最多 32 个与上游服务器的空闲长连接。如果后端服务器 A 处理请求极慢,其连接迟迟不释放,Nginx 的连接池中关于 A 的空闲连接数会迅速达到上限。此时,新的请求到来时,Nginx 发现没有可用的空闲长连接给 A,只能新建 TCP 连接,这增加了握手开销。同时,least_conn 统计的是当前正在处理的请求数,长连接的存在使得连接的生命周期变长,如果后端服务出现抖动,连接数的变化具有惯性,导致负载分配不均。为了解决这个问题,我们需要调整 keepalive 的值,使其与并发量匹配,而不是盲目设大。
如何通过参数调优改善负载分布
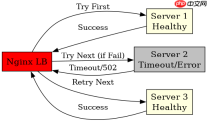
要改善负载不均,除了调整 keepalive 数量外,还需要引入超时和故障转移机制。proxy_next_upstream 指令允许我们在特定条件下(如超时、502 错误)将请求转发给下一个后端。结合 proxy_connect_timeout 和 proxy_read_timeout,我们可以强制切断那些响应过慢的长连接,从而降低它们在 least_conn 中的权重影响。另外,确保 proxy_set_header Connection "" 正确设置,以启用 HTTP/1.1 的 Keep-Alive,否则每次请求都会建立新连接,least_conn 的优势将无法发挥,且频繁建连本身就会造成负载波动。

upstream backend {
    least_conn;
    server 192.168.1.10:8080 max_fails=3 fail_timeout=10s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=10s;
    keepalive 16;
}

server {
    listen 80;
    location / {
        proxy_pass http://backend;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_connect_timeout 5s;
        proxy_read_timeout 30s;
        proxy_next_upstream error timeout invalid_header http_500 http_502 http_503;
    }
}
在这个优化后的配置中,我们为每个服务器添加了 max_fails 和 fail_timeout。这意味着如果某台服务器在 10 秒内失败 3 次,它将在 10 秒内被标记为不可用。这直接解决了长连接中因个别慢节点拖垮整体性能的问题。同时,keepalive 调整为 16,这是一个更保守的值,避免了过多空闲连接占用资源。 proxy_next_upstream 的配置确保了当某个后端响应超时或返回错误时,Nginx 会立即尝试下一个节点,而不是死守在一个已经过载或无响应的长连接上。这种组合策略使得 least_conn 能够基于更实时的健康状态进行调度,从而有效缓解长连接带来的负载不均问题。
不同 keepalive 值对负载的影响
为了验证 keepalive 值对负载分布的具体影响,我们可以观察在不同并发压力下,Nginx 如何管理上游连接池。当 keepalive 设置得远大于实际并发连接数时,多余的连接会成为内存负担,且在服务器重启或网络波动时,这些僵死连接会导致短暂的请求失败。相反,如果 keepalive 设置过小,Nginx 需要频繁地建立和销毁 TCP 连接,这不仅增加了 CPU 和带宽的开销,也使得 least_conn 算法难以积累足够的连接状态信息,导致负载分配趋于随机化,失去了“最少连接”的意义。因此,找到一个平衡点至关重要,通常建议将该值设置为 worker_connections * worker_processes / number_of_backends` 的一个子集,并根据实际监控数据进行微调。


