






在java gc日志中,识别full gc最直接的方法是查找包含“full gc”关键字的日志行。通常,这类日志会明确标注触发原因(如metaspace满、system.gc()调用或并发模式失败),并附带详细的内存统计信息,包括gc前后的堆内存使用量、耗时以及各代(young/old)的具体变化。通过解析这些字段,可以判断full gc是否导致了应用停顿(stop-the-world)以及内存回收的效果。
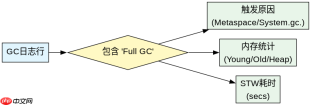
如何从日志行中提取Full GC的关键指标
要量化Full GC的影响,需要提取日志中的时间戳、总耗时、GC前/后堆大小等数据。标准的JDK 8及以前版本的日志格式较为固定,而JDK 9+引入了更结构化的日志输出。以常见的JDK 8格式为例,一行典型的Full GC日志如下:`[Full GC (Metadata GC Threshold) [PSYoungGen: 10240K->0K(196608K)] [ParOldGen: 500000K->450000K(524288K)] 510240K->450000K(720896K), 0.0523456 secs]`。这里的关键指标是`secs`后的数值,代表STW时长;`->`符号前后的数字分别代表GC前后该区域的内存占用。通过分析这些数据,可以评估Full GC对系统性能的具体冲击。
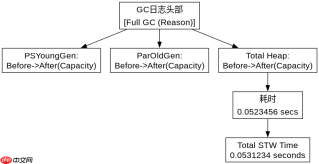
[Full GC (Metadata GC Threshold) [PSYoungGen: 10240K->0K(196608K)] [ParOldGen: 500000K->450000K(524288K)] 510240K->450000K(720896K), 0.0523456 secs]
Total time for which application threads were stopped: 0.0531234 seconds, Stopping threads took: 0.0001234 seconds
上述代码块展示了一行完整的JDK 8 Full GC日志。其中,`PSYoungGen`和`ParOldGen`分别表示年轻代和老年代的内存变化。括号内的第一个数字是GC前的使用量,第二个数字是GC后的使用量,最外层括号内是该代的总容量。例如,`510240K->450000K(720896K)`表示整个堆在GC前使用了510240K,GC后降为450000K,堆总容量为720896K。最后的`0.0523456 secs`是垃圾收集器执行的时间。紧随其后的`Total time for which application threads were stopped`提供了更精确的STW总时长,包含了线程挂起和恢复的开销。开发者应重点关注这个总时长,因为它直接对应应用的响应延迟。
不同JVM版本下Full GC日志格式的演变与解析差异
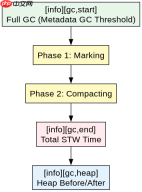
JDK 9之后,JVM引入了新的日志框架,默认输出格式更加易读且结构化。虽然核心信息不变,但呈现方式发生了显著变化。在新版日志中,Full GC事件通常以`[GC (Full) ...]`开头,并且会将各个阶段的动作拆分行显示,例如`[Pause Young (Normal)`, `[Pause Old (Metadata)]`等。这种拆分使得定位具体哪一代发生问题更加直观。此外,新版日志默认启用颜色编码(如果在支持颜色的终端中运行),并提供了更清晰的内存池名称,如`G1 Young Generation`而非旧的`PSYoungGen`。解析新版日志时,需适应这种多行输出的结构,通常最后一行会汇总整个Full GC的总耗时和内存结果。

[2023-10-27T10:00:00.000+0800][info][gc,init] Initializing G1 ...
[2023-10-27T10:05:00.000+0800][info][gc,start] Full GC (Metadata GC Threshold)
[2023-10-27T10:05:00.000+0800][info][gc,phases]   Phase 1: Marking
[2023-10-27T10:05:00.001+0800][info][gc,phases]   Phase 2: Compacting
[2023-10-27T10:05:00.050+0800][info][gc,end] Total time for which application threads were stopped: 0.0501234 seconds
[2023-10-27T10:05:00.050+0800][info][gc,heap]   Heap before GC invocations=10 (full 1): G1 Young RemSet Selection: 0.000 ms, G1 Young and Old: 0.050 ms
以上代码块展示了JDK 9+ G1 GC器的Full GC日志示例。可以看到,日志按时间戳排序,并分为`start`、`phases`、`end`和`heap`几个部分。`start`行确认了Full GC的发生及其原因(Metadata GC Threshold)。`phases`行详细列出了标记和压缩阶段,有助于深入分析GC内部行为。`end`行给出了关键的STW总时长。`heap`行则总结了GC前后的堆状态。对于开发者而言,解析新版日志时需要关注`start`行的原因和`end`行的总时长,同时利用`phases`行来诊断是否存在特定的阶段瓶颈,如标记阶段过长可能意味着对象图过于复杂。
当Full GC频繁发生时如何根据日志定位元空间溢出问题
如果日志中频繁出现Full GC,且原因是`Metadata GC Threshold`,这通常意味着Metaspace(元空间)已满。Metaspace用于存储类的元数据,如类结构、方法信息等。当加载的类过多或动态代理类生成过快时,Metaspace可能迅速耗尽。此时,Full GC会尝试回收Metaspace中的无用类。如果日志显示Metaspace在GC后仍然接近上限,或者Full GC间隔极短,说明类卸载机制未能有效释放内存。解决此问题的第一步是检查日志中Metaspace的使用量变化,确认是否确实因元空间不足触发。其次,应结合JVMTI工具或MAT(Memory Analyzer Tool)分析堆转储文件,找出加载了大量类的ClassLoader。常见原因包括未正确关闭的资源、动态生成的类库(如Groovy脚本引擎)或第三方框架的反射滥用。调整`-XX:MaxMetaspaceSize`参数可以暂时缓解,但根本解决需优化类加载逻辑或减少动态类生成。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


