






随着ai应用逐步从单次问答向长文本处理、多模态理解与智能体协作演进,推理调用量持续走高,算力成本与资源利用效率正日益成为规模化落地的核心瓶颈。当前产业竞争已不再单纯比拼单一硬件的峰值性能,更关键的是能否实现多样化算力资源的高效协同——在保障服务质量的前提下,显著降低单位token的生成成本。
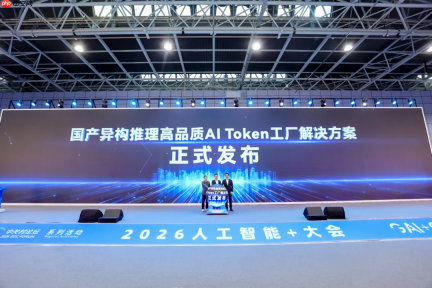
作为专注高品质AIToken生产的科技企业,趋境科技长期聚焦于AIToken生产体系构建及“AIToken工厂”的建设与运营。10月31日,公司正式推出“国产异构推理高品质AIToken工厂解决方案”,从技术架构、适配能力到实际应用价值三个维度同步突破,以系统级工程能力提升Token产出效率与经济性,加速高品质AIToken的大规模稳定供给与商业化交付。
架构层:全栈异构协同,释放多元算力潜能
大模型推理过程通常划分为Prefill(预填充)与Decode(解码)两个阶段,二者在计算密度、显存带宽、访存模式等方面存在显著差异。传统部署方式往往采用同构硬件全程承载,易导致部分资源闲置,推高整体TCO(总拥有成本)。为突破软硬割裂现状,实现异构资源的精准匹配与动态调度,本方案深度融合趋境科技自研的全系统异构协同推理技术:将高算力密度的硬件用于Prefill阶段,而将高带宽、大容量显存的设备专用于Decode阶段。方案将CPU、GPU、内存及高速互联网络统一纳入推理调度框架,在确保模型精度端到端无损、支持细粒度跨卡协同组网、并构建毫秒级无损容错机制的基础上,有效突破单芯片性能天花板与异构协同工程难题,在真实生产环境中实现算力向高品质、高性价比AIToken产能的稳定转化。
适配层:精模型、深优化、稳输出,构建“模型-推理-心片”正向循环

趋境科技坚持“精模型、深优化、稳输出”的技术路径,将系统工程重心集中于少数高价值、高通用性的主力模型,依托Prefill-Decode(PD)异构协同调度、高性能异构KVCache转换、以及异构计算融合三大核心技术,围绕模型适配、推理执行、KVCache生命周期管理、资源编排策略与服务运维等环节开展垂直深度优化。通过让不同硬件在最适合的任务节点上发挥最大效能,最终以单位资源的有效Token产出率与有效生产时间作为核心评估指标,为企业级业务打造兼具高智能响应、低延迟吞吐与强鲁棒性的推理底座。该路径填补了推理加速链条中的关键空白,真正实现“模”与“芯”的无缝对接、稳定运行与经济可用,推动“模型-推理-心片”闭环生态加速成型。
应用层:实产验证效能,规模化兑现Token价值
以高品质AIToken量产为目标,趋境科技国产异构PD方案已在多个生产级集群中完成部署,稳定支撑万亿参数级超大规模模型推理,并持续承接来自金融、政务、内容生成等领域的高并发真实业务请求。实测数据表明,该方案在企业核心推理场景中展现出显著的成本优势——在相同硬件投入前提下,可支撑更高密度、更高质量的AIToken输出需求。依托在全国多地落地的AIToken工厂,趋境科技正稳步推进AIToken的标准化、批量化生产与交付,切实将技术优势转化为商业价值,完成从技术到经济的完整闭环,助力国产AI算力走向普惠化、实用化与可持续化。
展望未来,趋境科技将持续深化推理底层架构创新,完善可复制、可扩展的标准交付体系,致力于将先进算力真正转化为“用得起、跑得稳、用得久”的智能生产力基础设施。








