






通过为 fetch 请求挂载全局的 beforesend 和 afterware 拦截器,可以在请求发出前注入唯一追踪 id,并在响应返回后统一收集状态码、耗时及错误信息。具体做法是重写或包装 fetch 函数,利用 promise 链捕获异常并上报数据,从而实现对所有接口请求结果的集中监控。

如何设计请求与响应的拦截流程
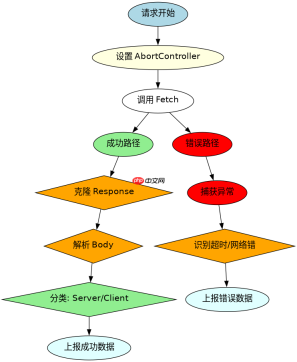
拦截流程的核心在于在原始 fetch 执行前后插入逻辑钩子。在请求发送阶段,生成唯一的 traceId 并将其附加到请求头中,同时记录开始时间戳;在响应处理阶段,无论请求成功还是失败,都计算总耗时,提取关键指标如 HTTP 状态码、URL 路径以及错误堆栈,最后将这些数据聚合到一个监控队列中。这种机制确保了每个请求都有迹可循,且不会遗漏任何异常场景。
// 定义监控配置
const monitorConfig = {
  reportUrl: '/api/monitor/report',
  batchSize: 10,
  flushInterval: 5000
};

// 存储待上报的数据
let requestQueue = [];
let timer = null;

// 核心拦截函数
function interceptFetch(originalFetch) {
  return function(url, options = {}) {
    const traceId = Math.random().toString(36).substr(2);
    const startTime = performance.now();

    // 注入追踪ID
    if (!options.headers) options.headers = {};
    if (typeof options.headers === 'object') {
      options.headers['X-Trace-Id'] = traceId;
    }

    return originalFetch(url, options)
      .then(response => {
        const duration = performance.now() - startTime;
        recordRequest({ url, status: response.status, duration, traceId, type: 'success' });
        return response;
      })
      .catch(error => {
        const duration = performance.now() - startTime;
        recordRequest({ url, error: error.message, duration, traceId, type: 'error' });
        throw error;
      });
  };
}

// 记录请求数据
function recordRequest(data) {
  requestQueue.push(data);
  if (requestQueue.length >= monitorConfig.batchSize) {
    flushQueue();
  }
}

// 批量上报
function flushQueue() {
  if (requestQueue.length === 0) return;
  const dataToSend = [...requestQueue];
  requestQueue = [];

  fetch(monitorConfig.reportUrl, {
    method: 'POST',
    body: JSON.stringify(dataToSend)
  }).catch(() => {
    // 上报失败则保留数据或丢弃,视业务需求而定
    console.warn('Monitor report failed');
  });
}
上述代码展示了如何包装 fetch。调用 interceptFetch(window.fetch) 并将结果重新赋值给 window.fetch 即可生效。当请求完成时,recordRequest 会将数据加入队列,达到阈值或超时后通过 flushQueue 批量上报至后端。这种方式避免了频繁的网络请求开销,同时保证了数据的完整性。
如何处理不同类型的网络异常与状态码
在处理异常时,需要区分网络层错误(如断网、DNS 解析失败)和应用层错误(如 404、500)。网络层错误会直接触发 catch 块,而应用层错误虽然返回了 Response 对象,但状态码非 2xx,需要在 then 中手动判断。对于 5xx 服务器错误,应标记为严重故障并可能触发告警;对于 4xx 客户端错误,通常记录日志即可。此外,还需处理超时情况,可以通过设置 signal 参数来实现。

// 增强版拦截器,包含超时控制和详细状态分类
function enhancedInterceptFetch(originalFetch) {
  return function(url, options = {}) {
    const controller = new AbortController();
    const timeoutId = setTimeout(() => controller.abort(), 5000); // 默认5秒超时

    const startTime = performance.now();
    const traceId = Math.random().toString(36).substr(2);

    // 合并信号
    const existingSignal = options.signal;
    options.signal = existingSignal ? AbortSignal.any([existingSignal, controller.signal]) : controller.signal;

    return originalFetch(url, options)
      .then(async response => {
        clearTimeout(timeoutId);
        const duration = performance.now() - startTime;

        let category = 'success';
        if (response.status >= 500) category = 'server_error';
        else if (response.status >= 400) category = 'client_error';

        // 获取响应体内容用于进一步分析(可选)
        let responseBody = null;
        try {
          responseBody = await response.clone().text();
        } catch(e) {}

        recordRequest({
          url,
          status: response.status,
          duration,
          traceId,
          category,
          responseBody: responseBody?.substring(0, 100) // 截断长文本
        });

        if (category === 'server_error') {
          // 可在此处触发即时告警
          console.error(`Server Error on ${url}: ${response.status}`);
        }

        return response;
      })
      .catch(error => {
        clearTimeout(timeoutId);
        const duration = performance.now() - startTime;
        let errorMsg = error.name === 'AbortError' ? 'Timeout' : error.message;

        recordRequest({
          url,
          error: errorMsg,
          duration,
          traceId,
          category: 'network_error'
        });

        throw error;
      });
  };
}
这段代码引入了 AbortController 来处理超时,并通过 response.clone() 安全地读取响应体而不影响后续业务逻辑。根据状态码将请求分类为 success、client_error、server_error 和 network_error,便于后端进行不同级别的统计和告警。例如,5xx 错误可以立即发送钉钉或邮件告警,而 4xx 错误仅做日志记录。
基于特定输入条件如何优化监控数据的上报频率
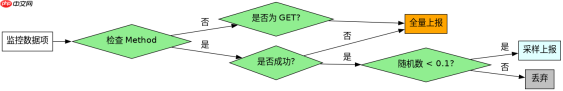
当系统中存在大量高频短连接请求时,全量上报会导致监控通道拥堵。针对这种情况,可以引入采样策略或动态调整上报频率。例如,对于成功的普通 GET 请求,可以按 10% 的比例采样上报;而对于 POST 请求或发生错误的请求,则全量上报。此外,还可以根据当前网络的 RTT(往返时间)动态调整批量大小,在网络状况良好时增加批量大小以减少请求次数。
shouldSample
大量免费API接口:立即使用
涵盖生活服务API、金融科技API、企业工商API、等相关的API接口服务。免费API接口可安全、合规地连接上下游,为数据API应用能力赋能!





