






java 中执行批量数据分表的核心做法是:使用 preparedstatement 的 addbatch() 和 executebatch() 方法,结合动态 sql 将数据分发到不同的物理表中。具体实现时,需根据业务逻辑(如用户 id 取模)计算目标表名,构建对应的 sql 语句,并将参数绑定后加入批次,最后统一提交。

如何根据条件动态选择目标表并构建 PreparedStatement
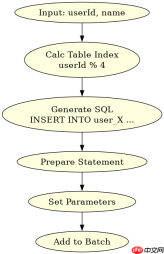
要实现分表,首先需要确定分表策略,例如通过 userId % 4 决定写入 user_0、user_1、user_2 或 user_3。在代码中,我们定义一个工具类方法来生成针对特定表的 SQL 模板,并利用 PreparedStatement 设置参数。这种方法避免了字符串拼接带来的 SQL 注入风险,同时保证了类型安全。
import java.sql.Connection;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class ShardingExecutor {
    private final Connection connection;

    public ShardingExecutor(Connection connection) {
        this.connection = connection;
    }

    // 向指定分表插入单条数据
    public void insertToTable(int userId, String name) throws SQLException {
        int tableIndex = userId % 4;
        String tableName = "user_" + tableIndex;
        String sql = "INSERT INTO " + tableName + " (user_id, name) VALUES (?, ?)";

        try (PreparedStatement pstmt = connection.prepareStatement(sql)) {
            pstmt.setInt(1, userId);
            pstmt.setString(2, name);
            pstmt.addBatch();
        }
    }

    // 执行所有已添加的批次
    public void executeAllBatches() throws SQLException {
        // 注意:实际应用中通常按表分组执行,这里简化为全局刷新
        // 由于 PreparedStatement 是按连接和语句对象管理的,
        // 更严谨的做法是为每个表维护独立的 PreparedStatement 实例
    }
}
上述代码展示了如何根据 userId 动态构建表名。关键点在于 tableName 是通过字符串拼接生成的,而参数部分始终使用 ? 占位符。这样既实现了分表路由,又保留了预编译的优势。需要注意的是,addBatch() 是针对当前 PreparedStatement 对象的,如果不同表使用不同的 SQL 语句,需要为每个表创建独立的 PreparedStatement 实例来分别调用 addBatch。
如何优化大批量分表插入的性能与事务管理
当数据量较大时,简单的逐条 addBatch 可能导致内存溢出或事务日志过大。优化的关键在于:1. 按目标表分组批次;2. 控制单次批次大小;3. 合理使用事务。我们可以创建一个更完善的执行器,它内部维护一个 Map,Key 为目标表名,Value 为该表的 PreparedStatement。每次插入时,检查该表是否已有准备好的语句,若无则创建;若有则直接 addBatch。当批次达到阈值或程序结束时,遍历 Map 执行 executeBatch 并清空。


import java.sql.Connection;
import java.sql.PreparedStatement;
import java.sql.SQLException;
import java.util.HashMap;
import java.util.Map;

public class OptimizedShardingExecutor {
    private final Connection connection;
    private final Map<string preparedstatement> statementMap = new HashMap();
    private static final int BATCH_SIZE = 1000;

    public OptimizedShardingExecutor(Connection connection) {
        this.connection = connection;
    }

    public void addInsert(int userId, String name) throws SQLException {
        int tableIndex = userId % 4;
        String tableName = "user_" + tableIndex;
        String sql = "INSERT INTO " + tableName + " (user_id, name) VALUES (?, ?)";

        PreparedStatement pstmt = statementMap.computeIfAbsent(tableName, key -> {
            try {
                return connection.prepareStatement(key);
            } catch (SQLException e) {
                throw new RuntimeException(e);
            }
        });

        pstmt.setInt(1, userId);
        pstmt.setString(2, name);
        pstmt.addBatch();

        // 检查是否需要执行当前表的批次
        if (pstmt.getMaxRows() == 0 || pstmt.getUpdateCount() >= BATCH_SIZE) { // 注意:getMaxRows/getUpdateCount 不直接反映 batch size
             // 更准确的方式是手动计数
        }
    }

    // 简化版:手动计数触发执行
    private Map<string integer> batchCounts = new HashMap();

    public void addInsertWithCount(int userId, String name) throws SQLException {
        int tableIndex = userId % 4;
        String tableName = "user_" + tableIndex;
        String sql = "INSERT INTO " + tableName + " (user_id, name) VALUES (?, ?)";

        PreparedStatement pstmt = statementMap.computeIfAbsent(tableName, key -> {
            try {
                return connection.prepareStatement(key);
            } catch (SQLException e) {
                throw new RuntimeException(e);
            }
        });

        pstmt.setInt(1, userId);
        pstmt.setString(2, name);
        pstmt.addBatch();

        int count = batchCounts.getOrDefault(tableName, 0) + 1;
        batchCounts.put(tableName, count);

        if (count >= BATCH_SIZE) {
            pstmt.executeBatch();
            pstmt.clearBatch();
            batchCounts.put(tableName, 0);
        }
    }

    public void flushAll() throws SQLException {
        for (PreparedStatement pstmt : statementMap.values()) {
            pstmt.executeBatch();
            pstmt.clearBatch();
        }
        batchCounts.clear();
    }

    public void close() throws SQLException {
        for (PreparedStatement pstmt : statementMap.values()) {
            pstmt.close();
        }
        statementMap.clear();
    }
}</string></string>
这个优化后的版本解决了两个问题:一是避免了对同一张表重复创建 PreparedStatement,提高了效率;二是通过 BATCH_SIZE 控制了单次批次的内存占用。在实际生产环境中,建议将 flushAll 放在事务的合适位置,确保数据一致性。此外,对于超大数据量,可以考虑异步线程池处理批次提交,进一步解耦主业务流程。
当用户ID为负数时,分表索引计算结果是什么
在 Java 中,取模运算 % 的结果符号与被除数相同。因此,如果 userId 为负数,例如 -5 % 4,结果为 -1。这会导致表名变为 user_-1,可能引发数据库表不存在或命名不规范的问题。解决此问题的标准做法是使用 Math.abs(userId) % 4 或 (userId & 0x7FFFFFFF) % 4 来确保索引为非负数。另一种更稳健的方法是使用 Integer.hashCode(userId) % 4,因为 hashCode 返回的是整数值,其分布更均匀且能处理负数情况(但需注意 hashCode 本身可能为负,所以仍需取绝对值或加偏移)。最推荐的做法是:int index = Math.floorMod(userId, 4),该方法专门用于处理负数的取模,保证结果始终在 [0, 4) 范围内。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


