






豆包工作于11月12日迎来重要更新,正式接入多款第三方大语言模型,并同步上线限时特惠计划。除原有的自研模型豆包2.1lite与豆包2.1pro外,用户 now 可额外选择 kimi k3.1pro、glm5.3、deepseek v4.1flash 等主流外部模型,模型选项覆盖范围由单一自研体系拓展至更广泛的行业头部阵容。
考虑到不同模型在推理成本、响应延迟及性能表现上的差异,豆包工作在模型选择界面明确标出各模型对应的额度消耗倍率——数值越低,单位任务所消耗的额度越少。用户可根据具体任务需求(如复杂度高低、时效性要求、预算限制等)自主权衡,灵活匹配最适配的模型。此举将抽象的模型能力差异转化为直观、可比的成本指标,显著提升了资源使用决策的透明度与可控性。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
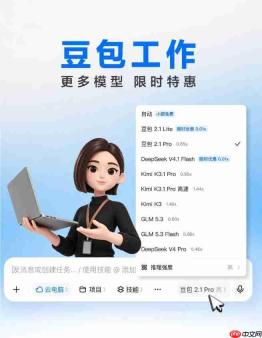
在权益策略方面,基础类轻量任务仍维持免费使用;与此同时,平台推出阶段性优惠活动:在工作日及节假日期间指定时段内调用参与活动的模型,即可享受额度消耗折扣。此外,豆包2.1Lite 与 DeepSeek V4.1Flash 的额度消耗倍率已同步下调,同等任务下额度消耗更低,整体使用续航能力进一步增强。

作为豆包面向专业办公场景打造的AI Agent型生产力工具,豆包工作能够理解用户目标、自主规划步骤并完成端到端任务执行与成果交付。即日起,新用户登录豆包工作电脑端,即可立即领取为期30天的免费订阅权益。
在当前多数Agent产品仍依赖单一自研模型作为底层支撑的行业常态下,豆包工作率先开放第三方模型接入,并全面公开计费倍率机制,标志着AI办公产品的竞争焦点正从“模型参数与能力”的单维比拼,转向“任务调度灵活性”与“单位算力性价比”的综合较量。对终端用户而言,这意味着可在同一工作流中按环节动态切换模型;对厂商而言,主动让渡模型选择权、提升定价透明度,也印证了AI办公工具正加速从封闭式体验迈向开放式模型生态的发展路径。



