






在 javascript web worker 中传递 idbindexinfo 对象,必须将其序列化为纯数据(plain object),因为该接口是只读视图且不可克隆。具体做法是在主线程通过 index.name、index.unique 和 index.multientry 提取属性构建新对象,再通过 postmessage 发送;worker 端接收后直接使用这些字段。

为什么不能直接传递 IDBIndexInfo 对象
Web Worker 与主线程之间的通信基于结构化克隆算法(Structured Clone Algorithm)。IDBIndexInfo 是一个包含指向数据库内部状态的引用类型的对象,它不是普通的 JSON 可序列化对象,也不支持结构化克隆。如果尝试直接将 IDBIndexInfo 实例放入 postMessage,浏览器会抛出 DataCloneError 异常,导致消息发送失败。因此,必须手动提取其内部的标量属性。
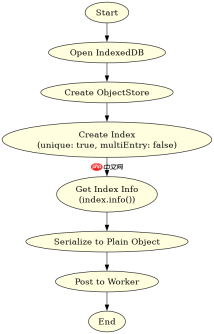
// main.js
const dbRequest = indexedDB.open('MyDatabase', 1);
dbRequest.onupgradeneeded = (event) => {
  const db = event.target.result;
  // 创建对象存储并添加索引
  if (!db.objectStoreNames.contains('users')) {
    const store = db.createObjectStore('users', { keyPath: 'id' });
    store.createIndex('email', 'email', { unique: true, multiEntry: false });
  }
};

dbRequest.onsuccess = (event) => {
  const db = event.target.result;
  const transaction = db.transaction(['users'], 'readonly');
  const store = transaction.objectStore('users');
  const index = store.index('email');

  // 获取索引信息
  const indexInfo = index.info();

  // 错误示范:直接传递会导致 DataCloneError
  // worker.postMessage(indexInfo);

  // 正确做法:提取为纯对象
  const serializableInfo = {
    name: indexInfo.name,
    unique: indexInfo.unique,
    multiEntry: indexInfo.multiEntry
  };

  const worker = new Worker('worker.js');
  worker.postMessage(serializableInfo);
};
上述代码展示了从 IDBIndex 调用 info() 方法获取 IDBIndexInfo 实例,并将其转换为包含 name、unique 和 multiEntry 属性的普通对象的过程。这个普通对象可以被安全地序列化并通过 postMessage 传输。
Worker 端如何解析和使用 IDBIndexInfo 数据
Worker 接收到的是包含 name、unique 和 multiEntry 属性的普通对象。由于失去了 IDBIndex 的实时连接能力,Worker 无法直接对该索引执行查询操作。通常,Worker 会将这些信息用于配置本地缓存策略、验证数据结构或生成日志报告。如果需要基于索引进行数据检索,应在主线程完成查询并将结果集返回给 Worker,而不是在 Worker 中尝试重建索引连接。

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
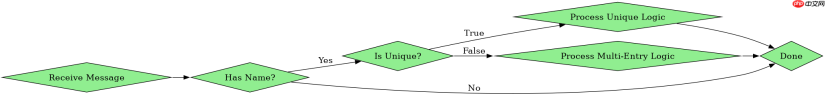
// worker.js
self.onmessage = (event) => {
  const info = event.data;

  // 验证接收到的索引配置
  if (info.name && typeof info.unique === 'boolean') {
    console.log(`Received index config: ${info.name}, Unique: ${info.unique}`);

    // 根据 unique 属性决定后续处理逻辑
    if (info.unique) {
      // 执行唯一性相关的业务逻辑
      performUniqueCheck(info.name);
    } else {
      // 执行非唯一性相关的业务逻辑
      performMultiEntryCheck(info.name);
    }
  }
};

function performUniqueCheck(indexName) {
  // 模拟基于唯一索引的处理
  console.log(`Processing unique index: ${indexName}`);
}

function performMultiEntryCheck(indexName) {
  // 模拟基于多值索引的处理
  console.log(`Processing multi-entry index: ${indexName}`);
}
Worker 端的代码演示了如何接收并处理来自主线程的索引信息。通过检查 unique 和 multiEntry 字段,Worker 可以调整其行为。需要注意的是,Worker 中的 info.name 仅作为字符串标识符使用,不具备实际的操作能力。
IDBIndexInfo 中 multiEntry 为 true 时的具体影响
当 IDBIndexInfo 中的 multiEntry 属性为 true 时,表示该索引允许键数组中的每个元素单独建立索引条目。这意味着如果一个对象存储中的记录其索引键是一个数组 ["a", "b"],且索引设置了 multiEntry: true,那么该记录会在索引中出现两次:一次对应键 "a",一次对应键 "b"。这会影响数据检索的范围和重复性。在主线程查询时,使用 index.get("a") 可能会返回多个匹配的记录(如果其他记录也包含 "a"),而不仅仅是单个记录。在 Worker 端接收到 multiEntry: true 的信息后,应意识到基于该索引的查询结果可能包含重复的主键记录,需要在应用层去重或特殊处理。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





