






java 日志中应记录能唯一标识请求上下文、反映业务逻辑关键节点以及辅助定位异常原因的核心数据,具体做法是包含 traceid、关键入参、处理结果及异常堆栈,避免记录敏感信息或过度详细的调试信息。

如何确保日志具备可追溯性
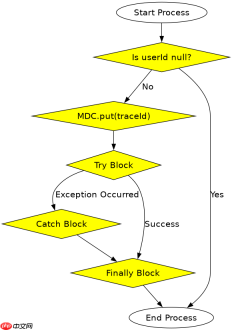
在分布式或并发环境中,单条日志往往难以串联起完整的调用链路,因此必须引入全局唯一的追踪标识。通常的做法是在请求入口处生成一个 TraceId,并通过 MDC(Mapped Diagnostic Context)将其绑定到当前线程的上下文中。这样,后续所有通过 SLF4J 或 Logback 输出的日志都会自动携带该 ID,无需在每个方法签名中手动传递。配置日志格式时,需在 PatternLayout 中加入 %X{traceId} 占位符,确保每条日志都能被聚合系统正确索引和检索。
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.slf4j.MDC;

public class TraceExample {
    private static final Logger logger = LoggerFactory.getLogger(TraceExample.class);

    public void processRequest(String userId) {
        // 模拟生成 TraceId
        String traceId = java.util.UUID.randomUUID().toString();
        MDC.put("traceId", traceId);
        try {
            logger.info("Processing request for user: {}", userId);
            // 业务逻辑...
        } finally {
            // 务必清理 MDC,防止线程池复用导致上下文污染
            MDC.clear();
        }
    }
}
上述代码展示了标准的 MDC 使用模式。输入为 userId,实际输出取决于日志配置文件中的 pattern。若 pattern 设置为 %d{HH:mm:ss.SSS} [%thread] %-5level %logger{36} - %X{traceId} - %msg%n,则控制台将打印类似 10:00:00.000 [main] INFO c.e.TraceExample - abc-123 - Processing request for user: u1 的内容。关键点在于 MDC.clear() 必须在 finally 块中执行,否则在线程池场景下,下一个任务可能会错误地继承上一个任务的 traceId,导致日志混乱。
异常日志应该记录哪些细节
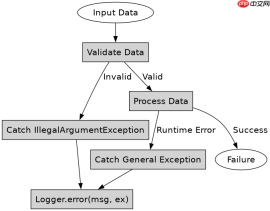
当程序发生异常时,仅记录异常消息往往不足以定位问题根源。正确的做法是记录完整的异常堆栈跟踪,并附带导致异常的关键业务状态。在 Java 中,这通常通过 logger.error("message", throwable) 的方式实现,而不是将异常转换为字符串后作为消息的一部分。同时,应避免记录异常的 cause 链中过于冗长的内部细节,除非这些细节直接指向业务逻辑错误。对于受检异常,需明确区分是重试可恢复的错误还是致命错误,并在日志级别上做出相应选择,例如网络超时可能用 WARN,而数据校验失败用 ERROR。

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;

public class ExceptionHandlingExample {
    private static final Logger logger = LoggerFactory.getLogger(ExceptionHandlingExample.class);

    public void handleData(String data) {
        try {
            if (data == null || data.isEmpty()) {
                throw new IllegalArgumentException("Data cannot be empty");
            }
            // 模拟业务处理
            process(data);
        } catch (IllegalArgumentException e) {
            // 记录错误日志,传入异常对象以保留堆栈
            logger.error("Invalid input data provided: {}", data, e);
        } catch (Exception e) {
            // 捕获其他未知异常,同样记录堆栈
            logger.error("Unexpected error during processing", e);
        }
    }

    private void process(String data) {
        // 假设这里可能抛出 RuntimeException
        if (data.contains("ERROR")) {
            throw new RuntimeException("Simulated failure");
        }
    }
}
运行上述代码,当输入 null 时,日志将输出:ERROR 级别的 "Invalid input data provided: null" 以及紧随其后的 java.lang.IllegalArgumentException: Data cannot be empty 堆栈。当输入包含 "ERROR" 时,将输出:ERROR 级别的 "Unexpected error during processing" 以及 java.lang.RuntimeException: Simulated failure 堆栈。这种记录方式确保了运维人员可以通过搜索异常类名或消息关键字快速定位问题,同时保留了调用栈信息以便分析代码执行路径。
基于程序中某个输入、条件或结果的具体问题
在之前的异常处理示例中,如果输入数据既为 null 又触发了后续的数据库连接异常,日志会呈现什么内容?在实际代码中,由于 try-catch 块的顺序执行特性,第一个匹配的 catch 块会被执行,后续的 catch 块将被跳过。因此,如果先捕获 IllegalArgumentException,即使后续代码因空指针引发其他异常,也只会记录 IllegalArgumentException 的信息。若要记录多个异常或最终的系统状态,应在 catch 块中显式记录当前上下文状态,或者使用更高级的日志框架特性如异常转换日志,但标准做法是确保每个异常点都有清晰的日志出口,且避免重复记录同一故障的不同阶段,除非它们属于不同的业务边界。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


