






告别手动卡点与硬切,通过字级时间戳对齐与自动化动效渲染,实现“声音落点即画面切换”的口播视频生产流程。
制作知识类或讲解类口播视频时,最耗时的环节往往不是拍摄,而是后期剪辑中逐帧调整字幕与画面的同步。传统流程需要对着时间轴一张张切图、卡节奏,最后往往只是简单的“一张图片配一段人声”,缺乏视觉流动性。为了解决这一痛点,可以引入基于代码的视频生成工作流,核心思路是将一份口播稿与一条成品配音作为输入,自动完成从声音到画面的精准映射。
先把稿子和配音对齐到时间轴
画面跟随语音的基础是精确的时间控制。传统的音频对齐通常以秒为单位,但对于快节奏口播,这种精度不足以支撑细腻的镜头切换。我们需要将声音落点精确到“字”的级别,确保每个动效节拍都有具体的触发点。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
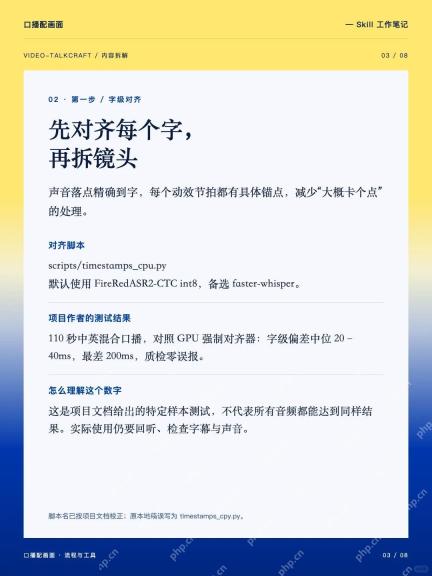
在技术实现上,可以使用如 scripts/timestamps_cpu.py 这样的脚本工具。该脚本默认调用 FireRedASR2-CTC int8 模型进行强制对齐,备选方案包括 faster-whisper。其工作原理是将口播文本与音频波形进行比对,生成包含每个字开始和结束时间的详细列表。这些时间戳数据随后会被拆解进 SHOTBOOK 分镜系统中,为后续的镜头分配提供依据。
需要注意的是,不同音频质量(如噪音、语速变化)会影响对齐效果。虽然特定样本测试显示偏差中位数在毫秒级,但在实际生产中,仍需人工回听并检查关键节点的字幕与声音是否完全吻合,避免机械对齐带来的微小错位。
跟着关键词安排画面和动效
有了时间戳后,下一步是为每个语义片段匹配视觉表现。这里采用“动效配方卡”的概念,将常见的视觉需求标准化。每张配方卡都包含了意图说明、参数设置以及已知的坑点提示。
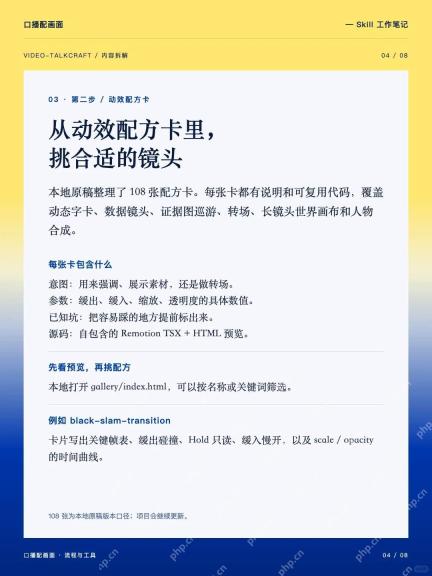
本地项目通常整理有上百张配方卡,覆盖动态字卡、数据镜头、证据图巡游、转场等多种场景。例如,对于强调观点的句子,可以选择“黑屏撞击转场”;对于展示数据的部分,则选择“数字滚动”组件。每张卡片都提供了自包含的 Remotion TSX 源码和 HTML 预览,你可以先在本地打开 gallery/index.html,按名称或关键词筛选,查看关键帧表、缓入缓出曲线及透明度变化,确认视觉效果符合预期后再将其应用到对应的时间段。
让镜头衔接跟上口播节奏
为了避免视频看起来像静止的 PPT 翻页,需要引入一套完整的镜头运动逻辑。这不仅仅是添加特效,而是对相机运动、元素出入场和场景衔接的整体规划。
首先,每个静态场景都应安排极缓的推进或拉出相机曲线,让画面始终处于微动状态,保持观众的视觉注意力。其次,利用“让位生命周期”和“六式转场”规则,确保元素有明确的进场和离场过程,场景之间通过运动承接,减少生硬的黑场硬切。
此外,排版纪律同样重要。根据语义拍拆分镜,严格控制同屏元素的数量,设置留白锚点。对于涉及人物出镜的画面,需使用人脸安全区检测脚本(如 scripts/face_bbox.py)测量边界,确保关键面部特征不被字幕或动效遮挡。同时,检测脚本会自动识别时间线上的静止段,提醒创作者在这些位置增加细微的动态元素。
导出前检查字幕、节奏和人物遮挡
渲染完成后,不能直接导出,而应经过三道机器审片流程的检查。第一道是画面健康双判定,通过静止段检测和并发画面抖动检测,找出时间线上可能出现的视觉问题。第二道是纯音效轨检查,逐 cue 验证能量,确保每个音效落点准确,而非仅检查音轨是否存在。第三道是动效点帧与独立评审,结合关键时刻的抽帧,检查构图与呈现细节。
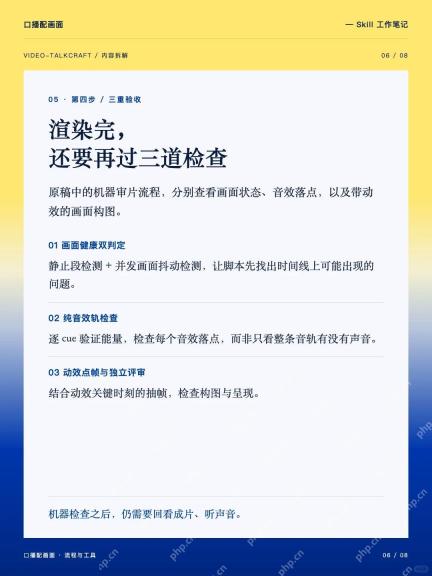
即使通过了机器检查,人工复核依然不可或缺。建议回看成片,重点聆听声音与画面的配合感。如果发现局部节奏不佳,可以利用项目自带的 Workbench 工作台进行调整。这个工作台提供了类似剪映的操作界面,允许你在时间线上继续修改镜头、文案和音效。对于更复杂的最终微调,还可以导出透明动效素材,导入剪映等专业软件进行最后的合成与调色。这种从代码生成到可视化编辑的混合工作流,既保证了批量生产的效率,又保留了精细调整的灵活性。






