在c#中,若需将全角空格(u+3000)与半角空格一同作为分隔符处理,最直接的做法是调用 string.split 方法并传入包含这两种字符的数组。具体而言,使用 new[] { ' ', '\u3000' } 作为参数即可一次性完成分割,返回的字符串数组会自动忽略前导和尾随的空格分隔符,从而得到纯净的数据片段。

Split 如何处理连续的分隔符?
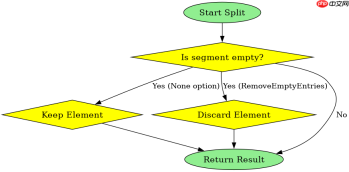
当输入文本中存在连续的全角或半角空格时,String.Split 默认会将它们视为单个分隔边界,不会生成空字符串元素。这种机制确保了即使数据源格式不规范,只要不包含有效内容,结果集中就不会出现无意义的空项。若业务逻辑确实需要保留这些空位,则必须显式指定 StringSplitOptions.RemoveEmptyEntries 之外的选项,但通常直接使用该默认行为即可满足大多数清洗需求。
using System;

class Program
{
    static void Main()
    {
        string input = "Hello\u3000\u3000World   Test";
        char[] separators = new[] { ' ', '\u3000' };

        // 默认行为:移除空元素
        string[] resultDefault = input.Split(separators);
        Console.WriteLine("Default: " + string.Join(",", resultDefault));

        // 保留空元素
        string[] resultKeep = input.Split(separators, StringSplitOptions.None);
        Console.WriteLine("Keep Empty: " + string.Join(",", resultKeep));
    }
}
如何自定义更复杂的分隔规则?
如果除了全角和半角空格外,还需要支持其他 Unicode 空白字符(如制表符),或者需要基于正则表达式进行匹配,可以使用 Regex.Split。这种方法允许定义更灵活的模式,例如 [\s\u3000]+ 可以匹配任意数量的标准空白符加上全角空格。虽然性能略低于 String.Split,但在处理非结构化文本时提供了更高的可控性,能够确保所有符合定义的空白类型都被正确识别为分隔点。


using System;
using System.Text.RegularExpressions;

class Program
{
    static void Main()
    {
        string input = "Hello\u3000World\tTest";
        // 匹配一个或多个普通空白符或全角空格
        string[] result = Regex.Split(input, @"[\s\u3000]+");
        foreach (var s in result)
        {
            Console.WriteLine(s);
        }
    }
}
全角空格在特定编码下是否会被误判?
在 UTF-8 编码中,全角空格 \u3000 占用三个字节(E3 80 80),而半角空格仅占一个字节(20)。在进行字节流处理或某些底层解析时,如果未正确识别字符边界,可能会将多字节字符截断导致乱码。因此,在使用 Encoding.UTF8.GetString 等转换操作后,再应用上述字符串分割方法是安全的。若在原始字节层面操作,建议先转换为字符串或使用支持 Unicode 的正则库,以避免因字节对齐问题导致的分隔失败。