






将一本书转化为ai知识库的核心方法是:先对文本进行清洗和分段,再利用提示词将内容提炼为“问题-答案-场景”的结构化数据,最后通过标签和页码索引建立检索体系。
直接将整本书上传给AI往往会导致重点模糊、回答跑偏,因为长文本中包含大量简介、背景等噪音。我们需要像整理仓库一样,先将知识拆解为独立的货架单元,再进行存储和管理。
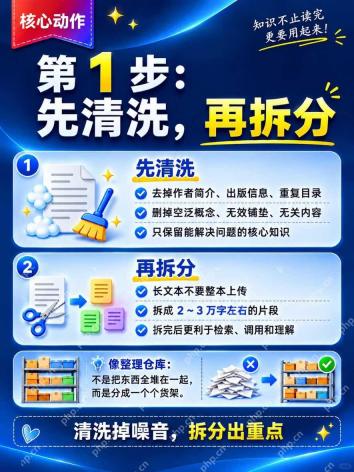
清洗与拆分长文本
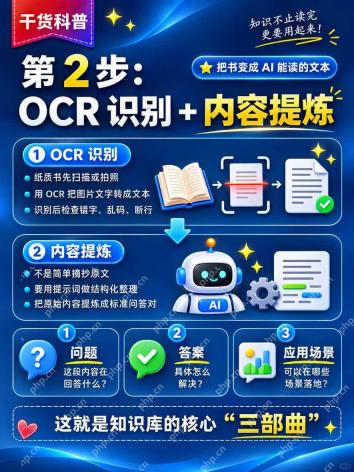
在开始处理之前,必须去除无效信息。对于纸质书,需先通过OCR识别转为文字;对于电子书,直接复制文本。清洗的重点是删除作者简介、出版信息、重复目录以及空泛的概念铺垫,只保留能解决具体问题的核心知识段落。
按章节或小主题拆分,让每段能回答一个明确的问题。保留定义、适用条件和例外情形。若试查时只能找到零碎信息,可以合并相邻段落,再用同一个问题重测。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
结构化提炼问答对
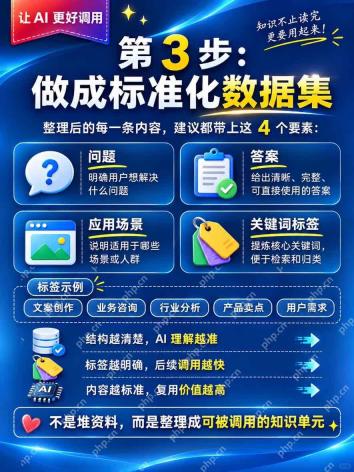
这是构建知识库最关键的一步。不要简单摘抄原文,而是要使用提示词将原始内容转化为标准化的数据集。每一条知识单元应包含三个核心要素:明确的问题、清晰的答案以及适用的应用场景。
你可以使用以下提示词模板来处理每一段清洗后的文本。请将待处理的文本替换到{{content}}位置:
请阅读以下文本片段,并将其转化为结构化的问答对。

要求:
1. 提取3-5个用户最可能提出的具体问题。
2. 基于文本内容给出准确、完整的答案。
3. 说明该知识点适用于哪些具体场景或人群。
4. 输出格式为JSON列表。

待处理文本:
{{content}}
添加标签与回查索引
为了让AI更精准地调用知识,需要为每条数据打上关键词标签并记录出处。标签应涵盖行业分析、业务咨询、产品卖点等维度,便于后续检索归类。
同时,务必保留章节页码或来源标识。这不仅有助于人工核对准确性,也能在AI生成回答时提供可信度背书。结构越清楚,AI理解越准;标签越明确,后续调用越快。
常见问题
A: 不要依赖AI自动修正所有错误。应先使用校对工具进行初步清理,再人工抽查关键段落。对于专业术语,建议在提示词中增加“保持专业术语原样”的指令,或在最终入库前手动修正高频错误词汇。
A: 在提炼问题时,确保问题本身包含足够的语境信息。例如,不要只问“价格是多少”,而应问“《XX书》中提到的XX产品定价策略是什么”。这样即使脱离原文,AI也能基于该独立单元给出准确回答。





