






java stream api 实现串行流处理的核心方法是调用 stream() 方法,或者在已有的并行流上调用 sequential() 方法。使用 stream() 创建的流默认就是串行的,操作会按顺序依次执行;而 sequential() 方法主要用于将并行流切换回串行模式,确保后续操作不再并发执行。
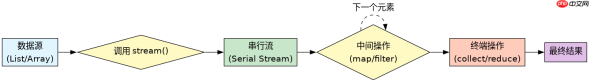
stream() 创建串行流的机制是什么
当从集合(如 List)或数组调用 stream() 时,返回的是一个典型的串行流。其背后的实现依赖于 Spliterator 的遍历特性。在串行模式下,Stream 内部维护一个游标,每次获取元素时都会同步地调用 Spliterator.tryAdvance()。这意味着所有中间操作(如 map、filter)和终端操作(如 collect)都在同一个线程中按数据源顺序依次完成。这种模式保证了操作的顺序性,无需额外的同步开销,适合处理量不大或对顺序敏感的场景。
import java.util.Arrays;
import java.util.List;

public class SequentialDemo {
    public static void main(String[] args) {
        List<string> data = Arrays.asList("A", "B", "C");
        // 直接调用 stream() 创建串行流
        String result = data.stream()
                .map(s -> s.toUpperCase())
                .reduce("", String::concat);
        System.out.println(result); // 输出: ABC
    }
}</string>
sequential() 如何改变并行流的行为
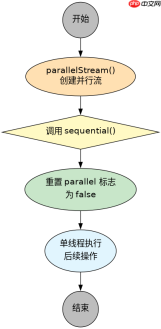
sequential() 是 BaseStream 接口定义的一个方法,它返回一个等效的串行流。这个方法通常用于当你通过 parallelStream() 创建了并行流后,发现某些操作需要严格顺序执行,或者为了调试方便而临时切换回串行模式。调用 sequential() 后,流的 parallel 标志位会被重置为 false。此时,即使之前已经建立了并行管道,后续的终端操作也会强制单线程执行。需要注意的是,如果在串行流上再次调用 sequential(),它会返回自身,不会产生新的对象实例,这是一种惰性且安全的操作。

import java.util.Arrays;
import java.util.List;

public class SequentialSwitchDemo {
    public static void main(String[] args) {
        List<integer> numbers = Arrays.asList(1, 2, 3, 4, 5);

        // 先创建并行流,再强制转为串行流
        int sum = numbers.parallelStream()
                .sequential() // 切换回串行模式
                .map(n -> n * 2)
                .reduce(0, Integer::sum);

        System.out.println(sum); // 输出: 30
    }
}</integer>
串行流在处理大数据量时的性能表现如何
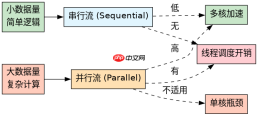
串行流由于没有多线程调度和上下文切换的开销,在小数据量或简单操作中往往比并行流更快。然而,当数据量极大且计算逻辑复杂时,串行流受限于单核 CPU 的处理能力,可能成为瓶颈。在实际开发中,如果不确定数据规模,建议优先使用串行流以保证确定性;若需提升性能,应结合 parallel() 并监控吞吐量变化。此外,串行流天然支持短路操作(如 findFirst),能更高效地提前终止遍历,这在并行流中较难优化。
大量免费API接口:立即使用
涵盖生活服务API、金融科技API、企业工商API、等相关的API接口服务。免费API接口可安全、合规地连接上下游,为数据API应用能力赋能!


