






在 java 中,使用 bufferedreader 读取字符流的核心做法是将其包装在 inputstreamreader 之上,并指定正确的字符编码(如 utf-8),从而将底层的字节流转换为高效的字符缓冲读取。这样做可以避免手动处理字节到字符的转换开销,并利用内部缓冲区提升 i/o 性能。

如何正确初始化 BufferedReader 以读取文件内容?
要正确初始化 BufferedReader,必须遵循“字节流 -> 转换流 -> 缓冲流”的包装顺序。首先通过 FileInputStream 打开文件获取原始字节,接着用 InputStreamReader 包裹字节流并声明编码格式,最后将转换流传入 BufferedReader 构造函数。这种链式调用确保了数据在从磁盘进入内存时能按正确的字符集解析,且具备缓冲能力。
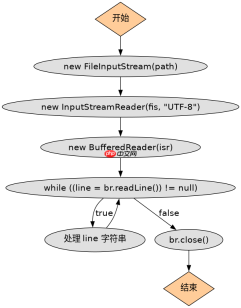
import java.io.BufferedReader; import java.io.FileInputStream; import java.io.IOException; import java.io.InputStreamReader; public class Main { public static void main(String[] args) throws IOException { // 1. 创建字节流 FileInputStream fis = new FileInputStream("data.txt"); // 2. 创建转换流,指定 UTF-8 编码 InputStreamReader isr = new InputStreamReader(fis, "UTF-8"); // 3. 创建缓冲字符流 BufferedReader br = new BufferedReader(isr); String line; while ((line = br.readLine()) != null) { System.out.println(line); } br.close(); }}
为什么推荐使用 readLine() 而不是直接读取单个字符?
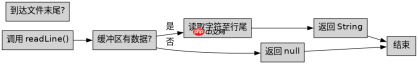
推荐使用 readLine() 是因为它专门针对文本处理优化,能够自动识别行终止符并返回完整的字符串,极大简化了代码逻辑。相比之下,直接读取单个字符需要开发者手动处理换行、回车等边界情况,且频繁的系统调用会导致性能下降。BufferedReader 的内部缓冲区会一次性读取大量数据,readLine() 在此基础上逐行提取,既保证了效率又提升了可读性。

import java.io.BufferedReader; import java.io.FileInputStream; import java.io.IOException; import java.io.InputStreamReader; public class Main { public static void main(String[] args) throws IOException { BufferedReader br = new BufferedReader(new InputStreamReader(new FileInputStream("data.txt"), "UTF-8")); String line; int lineCount = 0; while ((line = br.readLine()) != null) { lineCount++; } System.out.println("Total lines: " + lineCount); br.close(); }}
当 readLine() 返回 null 时意味着什么?
当 readLine() 返回 null 时,意味着已经到达输入流的末尾(End of Stream),没有更多的字符可供读取。这是判断循环结束的标准条件,表明文件已读完或连接已关闭。此时不应再尝试读取,而应正常关闭资源以避免内存泄漏或句柄占用。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


