






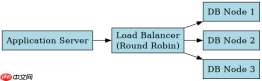
java preparedstatement 本身并不具备自动负载均衡能力,它仅负责将 sql 语句和参数安全地发送给当前连接的数据库实例。要实现批量数据的负载均衡,必须在应用层通过多数据源路由或分片策略,将不同的批次分配给不同的数据库连接执行。具体做法是维护一个活跃连接池列表,在提交批量任务时轮询选择目标连接,并将数据按主键范围或哈希值切分为多个子批次,分别调用 addbatch() 和 executebatch()。
如何配置多数据源以支持并行写入
实现负载均衡的第一步是建立多个独立的数据库连接对象,并管理它们的可用性。开发者需要创建一个容器来存储这些连接,例如使用 List。在初始化阶段,根据配置文件中的节点地址创建多个 DataSource 或直接获取 Connection。当需要执行批量操作时,从该列表中选取一个连接,准备 PreparedStatement。这种方式避免了单点瓶颈,使得写入压力分散到多个数据库实例上。关键在于确保每个连接都指向不同的物理节点,且事务隔离级别允许并发写入而不产生冲突。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.util.ArrayList;
import java.util.List;

public class MultiSourceBatchWriter {
    private List<connection> connections = new ArrayList();
    private int currentIndex = 0;

    public MultiSourceBatchWriter(String[] urls, String user, String password) throws Exception {
        for (String url : urls) {
            connections.add(DriverManager.getConnection(url, user, password));
        }
    }

    public void batchInsert(List<object> data) throws Exception {
        // 假设我们将数据平均分成 N 份,N 为连接数
        int batchSize = data.size() / connections.size();
        if (batchSize == 0) batchSize = 1;

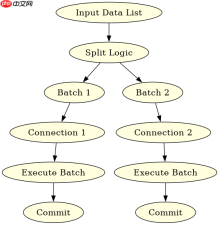
        for (int i = 0; i <p>上述代码展示了如何将输入的数据列表切分并分发到不同的连接中。每个连接独立执行 <code>executeBatch()</code>,从而实现了物理上的负载均衡。预期结果是所有数据被成功插入,且没有单连接过载的情况。注意,这里使用了简单的轮询索引 <code>currentIndex</code> 的变体(直接遍历),实际生产中应加入锁或原子计数器以保证线程安全。</p>
<h2>如何基于主键哈希进行数据分片</h2>
<p>除了简单的轮询分发,更常见的负载均衡策略是基于业务主键的哈希取模。这种方法能保证相同 ID 的数据始终落在同一个数据库节点上,便于后续查询时的路由一致性。在批量插入场景中,先遍历待插入数据,计算每条记录主键的哈希值,对节点数量取模,将数据归类到不同的队列中。然后,为每个队列创建一个对应的 <code>PreparedStatement</code> 并执行批量提交。这种方式的优点是数据分布均匀,缺点是如果主键分布不均可能导致负载倾斜。此外,还需要处理不同批次之间的事务独立性,通常建议每个分片独立事务,或者使用分布式事务管理器。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill12540" title="javascript-typescript-typescript-scaffold"><img
														src="https://img.php.cn/upload/skill/000/000/081/179439491442295.jpg" alt="javascript-typescript-typescript-scaffold" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill12540" title="javascript-typescript-typescript-scaffold" class="overflowclass">javascript-typescript-typescript-scaffold</a>
													<p class="overflowclass">你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill12540" title="javascript-typescript-typescript-scaffold" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div>
<p><img src="https://img.php.cn/upload/article/001/242/473/179438623439690.png?x-oss-process=image/resize,p_40" alt="Java PreparedStatement 怎么执行批量数据负载均衡"></p>
<pre class="brush:php;toolbar:false;">import java.sql.Connection;
import java.sql.PreparedStatement;
import java.util.*;
import java.util.stream.Collectors;

public class HashBasedShardingWriter {
    private List<connection> connections;

    public HashBasedShardingWriter(List<connection> conns) {
        this.connections = conns;
    }

    public void insertByHash(List<user> users) throws Exception {
        // 按主键哈希分组
        Map<integer list>> shards = users.stream()
            .collect(Collectors.groupingBy(u -> Math.abs(u.getId().hashCode()) % connections.size()));

        for (Map.Entry<integer list>> entry : shards.entrySet()) {
            Integer shardIndex = entry.getKey();
            List<user> shardData = entry.getValue();

            Connection conn = connections.get(shardIndex);
            conn.setAutoCommit(false);
            PreparedStatement ps = conn.prepareStatement(
                "INSERT INTO users (id, name) VALUES (?, ?)"
            );

            for (User u : shardData) {
                ps.setLong(1, u.getId());
                ps.setString(2, u.getName());
                ps.addBatch();
            }
            ps.executeBatch();
            conn.commit();
            ps.close();
        }
    }

    static class User {
        Long id; String name;
        User(Long id, String name) { this.id = id; this.name = name; }
        Long getId() { return id; }
        String getName() { return name; }
    }
}</user></integer></integer></user></connection></connection>
此段代码演示了如何利用 Java Stream API 将用户列表按主键哈希值分配到不同的分片。每个分片对应一个数据库连接,执行独立的批量插入。预期输出是所有用户数据根据其 ID 哈希值均匀分布在各个数据库中。这种方式比纯轮询更具确定性,适合需要按 ID 查询的场景。需要注意的是,hashCode()` 可能产生负数,因此使用 `Math.abs()` 或位运算确保索引为正。
当某个数据库节点宕机时程序如何处理异常
在批量负载均衡过程中,网络波动或数据库节点宕机是常见风险。如果某个连接在执行 executeBatch() 时抛出 SQLException,整个批次可能会失败。程序应当捕获该异常,记录日志,并尝试将该批次重新分配给其他健康的连接,或者标记该故障节点暂时不可用,从连接池中移除。重试机制应设置最大次数和退避策略,避免雪崩效应。此外,对于部分成功的批次,需要明确事务回滚逻辑,保证数据一致性。若采用最终一致性方案,可将失败数据写入死信队列,由后台任务异步重试。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


