






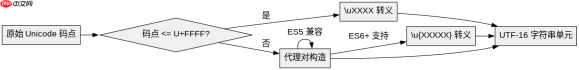
在 javascript 中,unicode 转义主要通过 \uxxxx 语法实现,用于在字符串或标识符中表示特定的 unicode 字符。对于基本多文种平面(bmp)内的字符,直接使用四个十六进制数字即可;而对于超出 bmp 的辅助平面字符,则需要使用代理对形式,即 \ud800\udc00 这种双字节组合,或者直接在 es6+ 环境中使用 \u{xxxxx} 的大括号语法。
如何表示基本多文种平面内的普通字符
对于码点在 U+0000 到 U+FFFF 之间的字符,可以直接使用 \uXXXX 格式,其中 XXXX 是四位十六进制数。这种方式在 ES5 及更早版本中广泛使用,适用于大多数常见拉丁字母、汉字和符号。
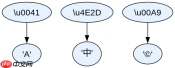
console.log("\u0041"); // 输出: A
console.log("\u4E2D"); // 输出: 中
console.log("\u00A9"); // 输出: ©
上述代码展示了三个典型示例:ASCII 字符 A、汉字 中 以及版权符号 ©。这些字符均位于 BMP 内,因此四位十六进制数足以唯一标识它们。在实际开发中,若需动态构建包含特殊字符的字符串,可直接拼接此类转义序列。
如何处理超出 BMP 的辅助平面字符
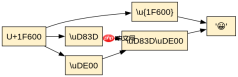
当字符的码点超过 U+FFFF 时,传统的 \uXXXX 无法直接表示,因为 UTF-16 编码采用代理对机制。ES6 引入了 \u{XXXXX} 语法,允许直接指定任意长度的十六进制码点,简化了处理过程。此外,也可以手动构造高代理项和低代理项的组合来实现兼容旧环境的效果。

// ES6+ 推荐方式
console.log("\u{1F600}"); // 输出: ?

// 兼容 ES5 的代理对写法
console.log("\uD83D\uDE00"); // 输出: ?
第一个例子使用了新的 \u{...} 语法,直接映射到表情符号 ? 的码点 U+1F600。第二个例子则展示了传统代理对的构成:\uD83D 是高代理项,\uDE00 是低代理项,两者组合后同样解析为 ?。开发者应根据目标运行环境选择合适的方式,现代项目优先使用大括号语法以提升可读性。
为什么某些 Unicode 转义在标识符中无效
JavaScript 允许在变量名、函数名等标识符中使用 Unicode 转义,但仅限于符合标识符命名规则的字符。例如,\u0041 可用作变量名 var \u0041 = 1;,但像 \u002D(连字符)这样的字符不能作为标识符的一部分,因为它属于标点符号类别。此外,控制字符和非打印字符通常被禁止用于标识符定义。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





