






配合分析的核心思路是先用gc日志定位发生full gc的时间点和触发原因,再用堆转储(heap dump)确认该时刻的具体内存占用情况。具体做法是先通过jvm参数开启详细gc日志,观察日志中full gc前后的内存变化曲线和触发事件;随后在full gc发生时或之后立即生成堆转储文件,使用mat等工具打开并分析大对象或内存泄漏路径。若日志显示频繁full gc但堆空间并未耗尽,通常指向内存泄漏或元空间问题;若堆空间确实被占满,则需结合日志中的分配失败记录,通过堆转储找出导致内存无法释放的引用链。

如何从GC日志中识别Full GC的触发原因
通过分析GC日志中的时间戳、内存使用量变化以及触发标记,可以明确Full GC是由老年代空间不足、元空间不足还是系统主动调用引起的。重点观察日志中出现的 Full GC (Ergonomics)、Full GC (Metadata GC Threshold) 或 Full GC (Allocation Failure) 等关键字,并结合 before 和 after 的堆内存数值判断是否因空间不足导致。如果日志显示 Metaspace 达到阈值,说明是类加载过多;如果显示 Old gen 容量不足,则是典型的内存溢出前兆。
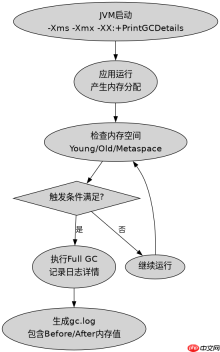
java -Xms512m -Xmx512m -XX:+UseG1GC -XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:gc.log -jar app.jar
上述命令启动了带有G1垃圾回收器的Java应用,并开启了详细的GC日志输出到 gc.log 文件。运行后,可以使用 grep 命令筛选出所有Full GC的记录: grep "Full GC" gc.log。查看输出结果,重点关注 [Times: user=... sys=... real=...] 之前的部分,这里记录了触发原因和GC前的内存状态。例如,若看到 Full GC (Allocation Failure) [PSYoungGen: ...] [ParOldGen: ...],则表明是因为年轻代向老年代分配数据时,老年代没有足够空间而触发的强制回收。
如何利用堆转储定位具体的内存泄漏对象
在确定Full GC触发点后,获取对应的堆转储文件并使用内存分析工具查找支配树(Dominator Tree)中的大对象。通过 jmap 命令生成堆转储,或使用JMX触发dump,得到 .hprof 文件。导入MAT后,选择 Histogram 查看对象数量分布,或使用 Leak Suspects Report 自动生成分析报告。重点检查 Shallow Size 和 Retained Size 差异巨大的对象,这些通常是导致内存无法回收的关键节点。


jmap -dump:format=b,file=heap.hprof <pid></pid>
该命令针对指定进程ID生成二进制格式的堆转储文件 heap.hprof。生成的文件可以直接拖入Eclipse MAT进行分析。在MAT界面中,点击 Dominator Tree 标签页,按 Retained Heap 降序排列。如果发现某个特定类的实例数量异常多且占据大量内存,右键点击该类并选择 Path to GC Roots -> with excluded references,即可看到阻止该对象被GC回收的引用链。这条链路直接指向了代码中未关闭的资源、静态集合缓存过大或监听器未移除等具体问题。
当GC日志显示正常但堆转储发现内存持续增长时如何处理
这种情况通常意味着存在缓慢的内存泄漏,或者GC日志未能捕捉到关键的分配细节。此时需要结合长期监控数据和多次堆转储进行对比分析。首先检查GC日志中的 GC overhead limit exceeded 警告,这表示GC花费了超过98%的时间却只回收了不到2%的堆内存。其次,对比不同时间点的堆转储,使用MAT的 Compare Two Histograms 功能,找出随时间推移数量显著增加的类。最后,审查代码中涉及长生命周期对象的逻辑,如单例模式中的集合、线程局部变量或第三方库的连接池配置。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


