






java jdbc 执行批量更新操作的核心方法是调用 connection 对象的 addbatch() 和 executebatch()。具体做法是:先获取 preparedstatement,在循环中设置参数并调用 addbatch() 将 sql 加入队列,最后调用 executebatch() 一次性提交。这样做能显著减少网络往返次数,提升大批量数据写入的性能。

如何配置连接以支持批量处理
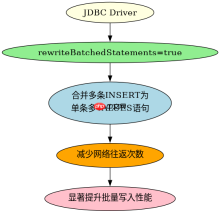
在使用 addBatch() 之前,必须确保数据库 URL 中启用了批量处理功能,否则驱动可能忽略批量指令或回退到单条执行。对于 MySQL,需要在 JDBC URL 中添加 rewriteBatchedStatements=true 参数,这样驱动会将多条语句合并为一条 INSERT ... VALUES (...), (...) 发送。如果不加此参数,虽然代码不报错,但性能优势会大打折扣甚至消失。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchUpdateExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 关闭自动提交,批量操作通常配合事务使用
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name, email) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i <p>上述代码展示了完整的流程:首先通过 URL 参数开启重写功能,然后关闭自动提交以确保数据一致性。在循环中,每次设置完参数后调用 <code>addBatch()</code> 累积操作。最后调用 <code>executeBatch()</code> 返回一个整型数组,表示每条语句影响的行数。如果发生异常,通过 <code>rollback()</code> 回滚事务,保证数据不会部分写入。</p><h2>如何处理批量更新中的异常与分批策略</h2><p>当数据量极大时,一次性将所有数据加入批次可能导致内存溢出或单次执行超时。最佳实践是将数据分成较小的批次(例如每批 500-1000 条),并在每批结束后检查执行结果。如果某一批次执行失败,可以针对该批次进行重试或记录错误日志,而不是中断整个任务。此外,<code>executeBatch()</code> 返回的数组中,值为 -2 表示语句成功执行但影响行数未知,值为 -3 表示语句被成功取消,其他正值表示受影响的行数。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill12496" title="Java 开发专家"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20d79f23518.jpg" alt="Java 开发专家" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill12496" title="Java 开发专家" class="overflowclass">Java 开发专家</a>
													<p class="overflowclass">精通 Java 21+,掌握虚拟线程、模式匹配和 Spring Boot 3.x 等现代特性。是 Java 生态系统(包括 GraalVM、Project Lo</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill12496" title="Java 开发专家" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div><p><img src="https://img.php.cn/upload/article/001/242/473/179438386130558.png?x-oss-process=image/resize,p_40" alt="Java JDBC 怎么执行批量更新操作"></p><pre class="brush:php;toolbar:false;">import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.util.ArrayList;
import java.util.List;

public class ChunkedBatchUpdate {
    private static final int BATCH_SIZE = 500;

    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true";
        String user = "root";
        String password = "password";

        List<string> names = generateLargeDataSet(); // 假设生成大量数据

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "UPDATE users SET email = ? WHERE id = ?";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                int count = 0;
                for (int i = 0; i  generateLargeDataSet() {
        List<string> list = new ArrayList();
        for (int i = 0; i <p>这段代码演示了分批处理的逻辑。通过设定 <code>BATCH_SIZE</code> 常量,在循环中累计计数,当达到阈值时调用 <code>executeBatch()</code> 并提交当前批次,随后立即调用 <code>clearBatch()</code> 清空缓冲区,防止内存堆积。循环结束后,检查是否还有剩余数据未处理,若有则再次执行。这种策略确保了即使数据量很大,也能稳定运行且易于监控进度。</p>
<h2>executeBatch() 返回数组中各状态值的含义是什么</h2>
<p><code>executeBatch()</code> 返回的 <code>int[]</code> 数组中,每个元素对应批次中一条 SQL 语句的执行结果。常见的返回值包括:正整数表示该行受影响的具体行数;<code>-2</code> 表示语句成功执行,但受影响的行数无法确定(常见于 DDL 或某些驱动行为);<code>-3</code> 表示语句被成功取消(通常发生在 <code>cancel()</code> 调用后);<code>SUCCESS_NO_INFO</code> 是 <code>-2</code> 的常量表示。如果抛出 <code>BatchUpdateException</code>,可以通过其 <code>updateCounts</code> 属性获取已成功执行的批次状态,从而判断哪些操作已完成,哪些失败。</p></string></string>
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


