






java jdbc 实现分库分表事务管理,核心在于放弃单一数据库的本地事务,转而采用基于全局唯一事务 id 的全局事务协调机制。具体做法是:在应用层维护一个全局事务上下文(threadlocal),为每个逻辑事务分配唯一的 transaction id;在执行跨库操作前,先向各数据源发起“开始事务”指令并绑定该 id;执行过程中,若某一步骤失败,则根据全局状态向所有已开启事务的数据源发送“回滚”指令,成功则发送“提交”指令。这种模式通过应用层代码显式控制事务边界和生命周期,确保分布式环境下的最终一致性。
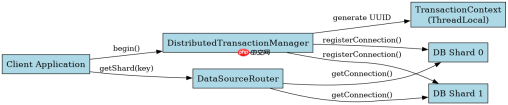
如何设计全局事务上下文与数据源路由
要实现上述机制,第一步是建立能够感知当前业务线程的事务上下文,并确保 SQL 能正确路由到对应的物理分片。我们使用 TransactionContext 类来存储全局事务 ID 和当前状态,利用 ThreadLocal 保证线程隔离。同时,需要一个 DataSourceRouter 根据业务键(如用户 ID)计算出目标数据源索引,从而获取正确的 Connection。这一步解决了“事务属于谁”以及“SQL 发给谁”的问题,为后续的多步操作奠定基础。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;
import java.util.HashMap;
import java.util.Map;

// 全局事务上下文
public class TransactionContext {
    private static final ThreadLocal<string> TRANSACTION_ID = new ThreadLocal();
    private static final ThreadLocal<integer> STATUS = new ThreadLocal(); // 0: active, 1: committed, 2: rolled back

    public static void begin() {
        TRANSACTION_ID.set(java.util.UUID.randomUUID().toString());
        STATUS.set(0);
    }

    public static String getTransactionId() {
        return TRANSACTION_ID.get();
    }

    public static int getStatus() {
        return STATUS.get();
    }

    public static void commit() {
        if (STATUS.get() == 0) STATUS.set(1);
    }

    public static void rollback() {
        if (STATUS.get() == 0) STATUS.set(2);
    }

    public static void clear() {
        TRANSACTION_ID.remove();
        STATUS.remove();
    }
}

// 模拟多数据源路由
public class DataSourceRouter {
    private static final Map<integer string> DB_URLS = new HashMap();
    static {
        DB_URLS.put(0, "jdbc:mysql://localhost:3306/db_0");
        DB_URLS.put(1, "jdbc:mysql://localhost:3306/db_1");
    }

    public static Connection getConnection(int shardIndex) throws SQLException {
        String url = DB_URLS.get(shardIndex % DB_URLS.size());
        return DriverManager.getConnection(url, "user", "password");
    }
}</integer></integer></string>
如何在跨库操作中执行提交与回滚
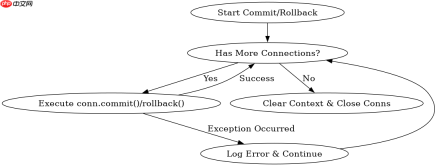
在有了上下文和路由后,第二步是实现具体的事务执行逻辑。我们需要一个 DistributedTransactionManager 来封装 begin、commit 和 rollback 行为。当调用 commit 时,管理器会遍历所有参与本次事务的连接,依次执行 connection.commit();当发生异常调用 rollback 时,同样遍历所有连接执行 connection.rollback()。关键在于,必须确保即使某个库的回滚失败,也要尝试清理其他库的状态,或者记录日志以便人工介入,但在基础实现中,我们主要关注标准流程的执行顺序和异常捕获。


import java.sql.Connection;
import java.sql.SQLException;
import java.util.ArrayList;
import java.util.List;

public class DistributedTransactionManager {
    private List<connection> connections = new ArrayList();

    // 注册参与事务的连接
    public void registerConnection(Connection conn) {
        try {
            conn.setAutoCommit(false);
            connections.add(conn);
        } catch (SQLException e) {
            throw new RuntimeException("Failed to set autoCommit", e);
        }
    }

    // 提交全局事务
    public void commit() {
        for (Connection conn : connections) {
            try {
                conn.commit();
            } catch (SQLException e) {
                // 实际生产中需记录错误并可能触发补偿机制
                System.err.println("Commit failed on connection: " + e.getMessage());
            }
        }
        TransactionContext.commit();
        cleanup();
    }

    // 回滚全局事务
    public void rollback() {
        for (Connection conn : connections) {
            try {
                conn.rollback();
            } catch (SQLException e) {
                System.err.println("Rollback failed on connection: " + e.getMessage());
            }
        }
        TransactionContext.rollback();
        cleanup();
    }

    private void cleanup() {
        for (Connection conn : connections) {
            try {
                conn.close();
            } catch (SQLException e) {
                e.printStackTrace();
            }
        }
        connections.clear();
        TransactionContext.clear();
    }
}

// 使用示例
public class Main {
    public static void main(String[] args) {
        try {
            TransactionContext.begin();
            DistributedTransactionManager txManager = new DistributedTransactionManager();

            // 假设根据 user_id=1001 路由到 db_0,user_id=2002 路由到 db_1
            Connection conn1 = DataSourceRouter.getConnection(0);
            Connection conn2 = DataSourceRouter.getConnection(1);

            txManager.registerConnection(conn1);
            txManager.registerConnection(conn2);

            // 执行 SQL...
            // conn1.prepareStatement("INSERT INTO users..." ).executeUpdate();
            // conn2.prepareStatement("INSERT INTO orders..." ).executeUpdate();

            txManager.commit();
            System.out.println("Transaction committed successfully.");
        } catch (Exception e) {
            TransactionContext.rollback(); // 简化处理,实际应调用 manager.rollback()
            System.out.println("Transaction rolled back due to error.");
        }
    }
}</connection>
如果第二个数据源连接超时,事务状态如何保持
当程序运行到第二节描述的 commit 或 rollback 阶段时,如果第二个数据源(db_1)发生网络超时或连接断开,conn.commit() 将抛出 SQLException。此时,第一个数据源(db_0)可能已经成功提交。由于我们的 DistributedTransactionManager 在循环中使用了 try-catch 块,第一个库的提交不会中断,但第二个库的提交会失败并被打印错误。这导致了一个不一致的状态:db_0 已提交,db_1 未提交。在这种基础实现下,事务无法自动恢复一致,必须由外部监控检测到该异常,并根据业务逻辑进行人工干预或异步补偿(例如,从 db_0 读取已提交数据,手动在 db_1 重放或标记失败)。因此,简单的 JDBC 分库分表事务仅能保证“全有或全无”的理想情况,在实际生产环境中,通常需要引入 TCC、Saga 或消息队列等更复杂的分布式事务方案来处理此类部分失败场景。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


