






人工智能赛道的性价比军备竞赛再添重磅新锐力量。11月9日,meta 官方正式推出其迄今体积最精简、运行效能最优的轻量级ai模型——muse ember。
聚焦高频场景:以极致能效支撑智能体持续高负荷运转
作为一款专注高效与轻量的核心模型,Muse Ember 的核心定位明确指向人工智能智能体(Agent)在日常运行中频繁执行的高频任务。典型应用场景包括工具调用、编程子任务执行、请求分发路由、结构化信息抽取,以及长篇文档深度解析等。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
在输入输出形态兼容性方面,该模型展现出卓越的多模态处理能力,可原生支持文本、图像、音频、视频及 PDF 等多种格式输入,并统一以纯文本形式输出结果。
百万级上下文窗口:单次请求从容应对超长代码与海量文档
在模型架构与容量设计上,Muse Ember 配备约100万 Token 的超大上下文窗口,最大输出长度可达约51.2万 Token。

赋予Agent实时语音交互能力。与Claude对话!超快TTS文字转语音,约90毫秒低延迟音频输出。
这一强大的长程理解与处理能力,使其能在单次推理中完整加载并分析大型代码仓库或整套技术文档体系,为开发者应对复杂工程任务提供了坚实可靠的底层模型支撑。目前,该模型已通过 Muse Code 平台及 Meta Model API 正式开放服务,统一模型标识为“muse-ember-1.0”。
权威评测出炉:综合性能比肩 Claude Haiku5.5,单次调用成本显著下探
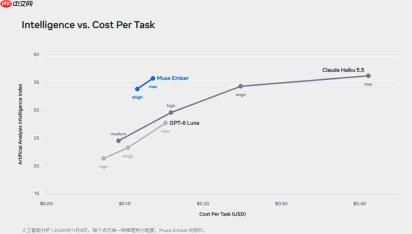
据第三方权威评测机构 Artificial Analysis 发布的最新评估报告,Muse Ember 在综合智能指数中斩获36分,与 Anthropic 推出的 Claude Haiku5.5 最高推理档位表现完全一致。
而在用户尤为关注的使用成本维度,Muse Ember 表现出显著优势。其官方定价为:每百万输入 Token 收费0.10美元、缓存输入费用0.004美元,每百万输出 Token 收费0.50美元。Artificial Analysis 实测数据显示,其最高推理档位单次任务平均成本约为0.14美元;相较之下,Claude Haiku5.5 执行同类任务的成本则达约0.41美元,前者成本仅为后者的约三分之一。
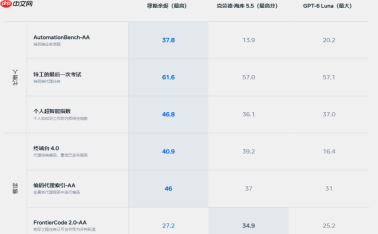
当然,不同评测体系下的结果亦呈现差异化倾向。Meta 自行公布的测试表明,Muse Ember 在智能体行为建模、工具链调用响应及多模态任务协同等方向的表现优于 Claude Haiku5.5 和 OpenAI 的 GPT-6Luna;但在 FrontierCode2.0 这一聚焦“代码修改是否被真实项目维护者接受”的专项评估中,其得分略逊于 Claude Haiku5.5。






