






在avro序列化中处理java optional 的空值,核心做法是自定义 specificdatumreader 和 specificdatumwriter,并在其中拦截 optional 类型的字段。当遇到 optional.empty() 时,将其转换为avro模式中的默认值(如 null 或特定常量),从而避免抛出 nullpointerexception 或导致序列化失败。

如何配置自定义的DatumReader/Writer以支持Optional
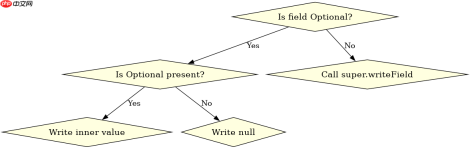
要实现这一功能,需要创建一个继承自 SpecificDatumReader 和 SpecificDatumWriter 的类,并重写 readField 和 writeField 方法。在这些方法中,检查当前字段的类型是否为 Optional,如果是,则根据 Optional 的状态决定写入什么值或读取什么对象。
import org.apache.avro.specific.SpecificDatumReader;
import org.apache.avro.specific.SpecificDatumWriter;
import org.apache.avro.io.DatumReader;
import org.apache.avro.io.DatumWriter;
import org.apache.avro.Schema;
import java.util.Optional;

public class OptionalAwareDatumReader extends SpecificDatumReader {
    public OptionalAwareDatumReader(Schema schema) {
        super(schema);
    }

    @Override
    protected Object readField(Object old, int fieldPos,
                               Schema schema, Decoder in,
                               ResolvingDecoder reader,
                               int index) throws IOException {
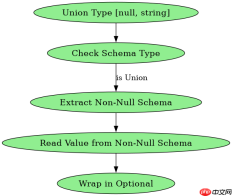
        if (schema.getType() == Schema.Type.UNION) {
            // 处理Union类型,例如 [null, String]
            Schema nonNullSchema = schema.getTypes().stream()
                .filter(s -> s.getType() != Schema.Type.NULL)
                .findFirst().orElse(null);
            if (nonNullSchema != null) {
                Object value = reader.readField(old, fieldPos, nonNullSchema, in, reader, index);
                return Optional.ofNullable(value);
            }
        }
        return super.readField(old, fieldPos, schema, in, reader, index);
    }
}

public class OptionalAwareDatumWriter extends SpecificDatumWriter {
    public OptionalAwareDatumWriter(Schema schema) {
        super(schema);
    }

    @Override
    protected void writeField(Object datum, int fieldPos,
                              Schema schema, Encoder out,
                              ResolvingDecoder writer,
                              int index) throws IOException {
        if (datum instanceof Optional) {
            Optional> opt = (Optional>) datum;
            if (opt.isPresent()) {
                // 写入Optional内部的值
                writer.writeField(opt.get(), fieldPos, schema, out, writer, index);
            } else {
                // 写入null
                writer.writeField(null, fieldPos, schema, out, writer, index);
            }
        } else {
            super.writeField(datum, fieldPos, schema, out, writer, index);
        }
    }
}
预期结果:使用上述自定义读写器后,包含 Optional 字段的记录可以正常序列化和反序列化,空值被正确映射为Avro的 null。
如何处理Avro模式中定义的Optional字段
在Avro模式中,Optional 通常表示为一个联合类型(Union),例如 ["null", "string"]。在使用自定义读写器时,需要确保模式定义与Java代码中的 Optional 类型一致。如果模式中没有定义联合类型,则需要修改模式或使用默认值。

import org.apache.avro.file.DataFileWriter;
import org.apache.avro.file.DataFileReader;
import org.apache.avro.io.DatumReader;
import org.apache.avro.io.DatumWriter;
import org.apache.avro.Schema;
import org.apache.avro.generic.GenericData;
import java.io.File;
import java.io.ByteArrayOutputStream;
import java.io.ByteArrayInputStream;

// 假设有一个生成的Avro记录类 MyRecord
public class AvroOptionalExample {
    public static void main(String[] args) throws Exception {
        Schema schema = new Schema.Parser().parse(
            "{\"type\": \"record\", \"name\": \"MyRecord\", \"fields\": [{\"name\": \"field1\", \"type\": [\"null\", \"string\"], \"default\": null}]}");

        MyRecord record = new MyRecord();
        record.setField1(Optional.of("test"));

        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        DatumWriter<myrecord> writer = new OptionalAwareDatumWriter(schema);
        DataFileWriter<myrecord> dataFileWriter = new DataFileWriter(writer);
        dataFileWriter.create(schema, baos);
        dataFileWriter.append(record);
        dataFileWriter.close();

        ByteArrayInputStream bais = new ByteArrayInputStream(baos.toByteArray());
        DatumReader<myrecord> reader = new OptionalAwareDatumReader(schema);
        DataFileReader<myrecord> dataFileReader = new DataFileReader(bais, reader);
        MyRecord readRecord = dataFileReader.next();
        System.out.println(readRecord.getField1().orElse("default"));
    }
}</myrecord></myrecord></myrecord></myrecord>
预期结果:程序输出 test,表明 Optional 中的值被正确序列化和反序列化。
当Optional为空时,Avro序列化会返回什么
当 Optional 为空时,自定义的 OptionalAwareDatumWriter 会将该字段写入Avro数据流中的 null。在反序列化时,OptionalAwareDatumReader 会检测到 null 并将其包装为 Optional.empty()。因此,最终得到的 Optional 对象将是空的。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


