






php实现敏感词过滤通常采用dfa(确定有限状态自动机)算法,核心做法是构建一棵前缀树来存储敏感词库,并在遍历文本时进行匹配。具体而言,你需要将敏感词列表预处理成嵌套数组或对象结构,然后在扫描用户输入时,从当前字符对应的节点开始向下查找,一旦遇到标记为“结束”的节点即判定命中,并根据需求替换为星号或直接拦截。这种方法相比正则表达式能显著降低时间复杂度,适合处理大规模词库。
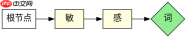
DFA前缀树的构建逻辑是什么
DFA前缀树的构建是将线性敏感词转化为层级结构的过程。每个节点代表一个字符,如果该字符是某个敏感词的结尾,则在该节点上设置特殊标记。构建时,依次读取敏感词中的每个字符,若当前节点的子节点中不存在该字符,则创建新节点;若存在,则移动到该子节点继续处理下一个字符。最终,所有敏感词的路径都会汇聚到这棵树中,共享公共前缀以节省空间。
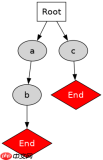
<?php class DfaFilter {
    private $tree = [];

    public function addWord($word) {
        $node = &$this->tree;
        for ($i = 0, $len = strlen($word); $i  false, 'children' => []];
            }
            $node = &$node['children'][$char];
        }
        $node['is_end'] = true;
    }

    public function build() {
        // 预处理完成,树已构建
    }
}
$filter = new DfaFilter();
$filter->addWord('bad_word');
$filter->addWord('another_bad');
$filter->build();
?>
如何遍历文本并执行敏感词匹配
匹配过程是对输入字符串进行逐字扫描。对于每个起始位置,尝试沿着前缀树向下匹配。如果匹配成功且到达结束节点,则记录该敏感词的范围;如果中途失配,则回到下一个起始位置继续尝试。为了提高效率,通常会使用双指针或滑动窗口的方式,避免重复检查。当发现敏感词后,可以根据策略选择跳过已匹配的字符长度,或者仅替换第一个字符。

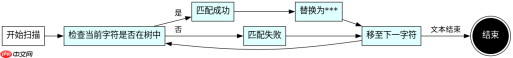
<?php public function check($text) {
    $len = strlen($text);
    $result = [];
    for ($i = 0; $i < $len; $i++) {
        $node = &$this->tree;
        $matchLen = 0;
        for ($j = $i; $j  $i,
                        'end' => $j,
                        'word' => substr($text, $i, $matchLen)
                    ];
                    break; // 找到最长匹配或首个匹配
                }
            } else {
                break;
            }
        }
    }
    return $result;
}
?>
匹配到敏感词后如何进行替换处理
在获取到敏感词的位置信息后,替换操作可以通过字符串拼接或原地修改来实现。常见的做法是创建一个新字符串,将非敏感部分原样保留,将敏感部分替换为指定长度的星号或其他掩码字符。为了保持原文本长度不变,可以使用`str_repeat('*', $length)`生成等长的替换串。此外,还需注意处理重叠敏感词的情况,通常优先匹配最长的词,或者按出现顺序依次处理,避免索引错乱。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


