





本文详解如何在 python 中安全、准确地解析具有动态长度字符串字段(由前置 uint16 指定字节数)的二进制文件,重点解决因结构体对齐导致的读取偏移错误及解码失败问题。
本文详解如何在 python 中安全、准确地解析具有动态长度字符串字段(由前置 uint16 指定字节数)的二进制文件,重点解决因结构体对齐导致的读取偏移错误及解码失败问题。
在解析自定义二进制格式(如测序索引文件 IndexMetricsOut.bin)时,一个常见却极易出错的环节是:按固定字段读取后,依据紧随其后的长度字段(如 indexLength: uint16)读取后续变长字符串。你遇到的 index_len: 16705 和 UnicodeDecodeError: 'utf-8' codec can't decode byte 0xa9 等异常,并非编码问题,而是结构体解包时因默认平台对齐引入了填充字节,导致 struct.unpack("HIHH") 实际读取了 12 字节而非预期的 10 字节,从而将后续数据错位解释为 indexLength,引发连锁解析错误。
✅ 正确做法:显式指定字节序与紧凑对齐
Python 的 struct 模块默认使用本机字节序和对齐规则(@),其中 I(uint32)要求 4 字节对齐,而前一个 H(uint16)仅占 2 字节,因此会在 H 和 I 之间插入 2 字节填充 —— 这直接破坏了二进制协议的连续性。解决方案是强制使用无填充的紧凑格式,并明确字节序(通常为小端 ,需根据实际文件规范确认):
炫酷的jQuery二进制数字时钟
下载
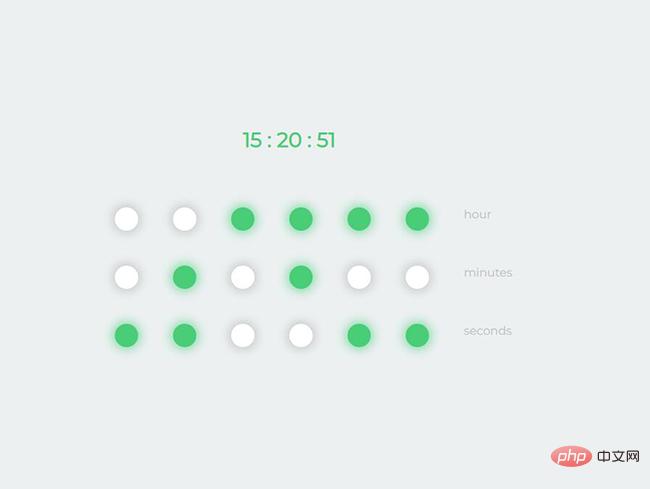
炫酷的jQuery二进制数字时钟,它的时分秒都是用二进制来表示,绿色表示该位值是1,灰色则表示0,原理是将时钟的时分秒分别实时转换成二进制,然后随着本地时间的更新而实时刷新
(小端)适用于 Intel/AMD 架构生成的多数生物信息学二进制文件;若不确定,请用十六进制编辑器(如 xxd)查看原始字节并比对字段值。


