





当前,大模型在多项高难度任务中已展现出突破性进展:数学推理方面,可辅助验证菲尔兹奖级别猜想;科研写作方面,能生成达到硕士或博士论文水准的文本;分子科学领域,可在数秒内完成候选化合物结构的推演。在多模态方向,大模型同样快速演进,在ocr、文档解析等视觉文档理解任务上的性能已逼近甚至超越实用门槛。然而,澳鹏数据最新评测揭示了一个关键落差:在批改一张小学三年级试卷这一基础教育任务上,五款主流模型的整页判分准确率仅为33.22%–58.18%,表明其高阶推理能力尚未有效迁移至真实世界的文档理解场景。
尽管多模态模型在文字识别、文档解析等单点任务上持续提升,但教育场景对AI提出的是端到端一体化能力要求:需从一张完整试卷中准确理解题目意图、精准识别学生实际作答内容,并严格依据页面可见证据完成判分。而现有评测体系难以系统评估这种贯穿识别、定位、理解与决策的全流程能力。针对这一现实挑战,澳鹏数据正式推出ExamOCRBench——一个以“端到端整页判分”为核心目标的多任务评测基准,旨在为教育AI构建更贴近真实课堂环境的能力检验框架。
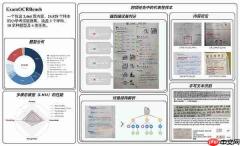
澳鹏数据ExamOCRBench:以端到端整页判分为核心的多任务评测基准
端到端整页判分:单项能力基准与复合任务之间的鸿沟
近年来,多模态模型在文字识别、版面分析、目标检测、视觉问答等单项评测中屡破纪录,自动批改也成为教育科技领域的重点研究方向。但真实教学场景中的批改任务与单项测试存在本质差异:在判断答案正误前,模型必须首先准确定位对应题干、识别学生最终提交的有效作答、区分划掉内容与保留答案,并结合上下文理解作答逻辑。该链路中任一环节失效,都将直接导致判分偏差。
更值得警惕的是潜在行为偏差:模型可能擅自修正学生拼写错误、将被划除的答案误判为有效作答,或在听力音频缺失等关键证据不全时强行输出评分。问题的核心并非模型能否解出题目,而在于能否稳固维持“题目—学生最终作答—判分结论”三者间的逻辑一致性与证据依赖关系。
真实试卷构建:整页全对仍是当前模型的重大短板
澳鹏ExamOCRBench基于中国小学2,464份真实试卷页面构建,涵盖语文、数学、英语三大主科,包含多样拍摄条件、手写涂改痕迹、不完整作答及复杂排版。判分任务关联22,636道小题,题型以语言填空、选择题、简答题和解答题为主,覆盖十类细分题型。标注采用“页面—大题—小题—答题区域”的四级结构,完整保留学生最终呈现的答案,包括错别字、涂改与重写内容。参考答案经人工校验与多轮质量审核后形成标准标签。全部共享页面共衍生24,928个评测实例。
基准核心指标PageScoreAccuracy要求页面内所有可判分单元全部正确,任一单元出错即整页判为失败。参与评测的五款模型中,GPT-6Astra以58.18%居首,GPT-5.6Sol为53.41%,Qwen3.8-Max、ClaudeOpus5与Doubao-Seed-2.1-Pro分别为42.32%、36.75%和33.22%。即便表现最优的模型,仍有超四成试卷无法实现整页全对,印证了真实、动态、非结构化的课堂文档对当前多模态模型构成实质性挑战;SafetyUnitRecall指标进一步考察模型在证据缺失等异常情况下主动拒绝判分的能力,当前最高召回率仅为41.04%,反映出模型在可靠性与审慎性方面仍有显著提升空间。
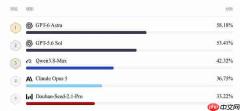

参与评测的五个主流模型:即使表现好的模型仍有四成以上页面无法做到全部判对
多项诊断任务拆解端到端判分的关键难点
澳鹏ExamOCRBench设置三项独立诊断任务:结构解析、内容定位与手写文本识别,分别评估模型对题目与作答层级关系的理解能力、在整页中精确定位目标证据的能力、以及忠实还原学生手写笔迹的能力。诊断结果呈现明显能力错配现象:GPT-5.6Sol整页判分排名第二,但手写识别完全匹配率却显著偏低;Qwen手写识别匹配率领先,整页判分准确率仅为42.32%。这说明判分能力与识别能力并不同步,答案推理与原始信息保真属于两种需独立建模与评估的核心能力。
另一项关键发现是模型普遍缺乏“弃权意识”:五款模型的无依据批改率高达58.96%-91.94%。在证据不足、图像模糊或关键信息缺失时,能够主动识别风险并拒绝输出结果,是教育AI可信落地的前提。在教学场景中,将错拼单词自动补全为正确形式,或将难以辨识的潦草字迹替换为符合题意的标准答案,不仅违背评估本意,更会掩盖学生真实的学习漏洞。
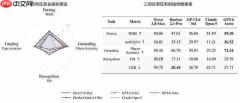
为什么整页判分仍然困难?澳鹏ExamOCRBench用三项诊断任务拆开观察
为教育AI选型与模型迭代提供可信赖的评测依据
澳鹏ExamOCRBench的价值在于将评测锚定于一张真实试卷从图像输入到最终判分输出的完整闭环。面向智能批改、作业数字化归档、错题归因分析与个性化学习反馈等典型应用,该基准不仅提供贴近学生真实作答习惯的评估视角,还将最终判分表现与底层结构理解、内容定位精度、手写识别保真度等能力维度建立映射关系,从而为教育AI产品选型与模型优化提供可解释、可归因的数据支撑与训练指引。目前,澳鹏ExamOCRBench已在GitHub与HuggingFace平台全面开源。
ExamOCRBench的发布,是澳鹏在高质量教辅试题数据体系建设中的关键实践之一。截至目前,澳鹏已积累覆盖K12基础教育、大学及研究生阶段、学科竞赛等多个学段与类型的教辅试题数据集,可全面支持大模型学科微调、解题能力评测与教育AI系统研发等多样化需求。未来,澳鹏ExamOCRBench将持续拓展学科广度与年级深度,重点增强对涂改痕迹、多步逻辑推导、图文混合题型及开放式表达等复杂作答形态的理解能力,推动评测结果更扎实地服务于智能批改、学情诊断与自适应学习反馈等实际教育场景。





