





音述ai电脑版入口在哪里?这是不少网友都关注的,接下来由php小编为大家带来音述ai网页端工作台入口链接,感兴趣的网友一起随小编来瞧瞧吧!
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
风格覆盖广度
1、平台提供古风、说唱、R&B、电子、摇滚、民谣、儿歌、影视配乐等12大类音乐风格,每类展开后均含5至15种子风格,例如“水墨江南”“市井方言flow”等具象化命名,全部可即时调用无需额外激活。
2、所有子风格均经过中文语境适配,节奏断句贴合普通话四声变化,副歌旋律线设计兼顾短视频传播所需的强记忆点与自然呼吸感。
3、风格模板支持组合叠加,如在“华语流行”基础上叠加“80年代磁带质感”或“地铁报站采样”,系统自动匹配对应混响参数与频段衰减曲线。
4、未采用通用流派标签,而是构建本土化描述体系,像“胡同大爷”“AI小评书”等声线名称直接关联声音气质与使用场景,降低风格选择认知门槛。
声线定制能力
1、内置87种中文定制声线,按男声、女声、童声、特色声四大维度组织,每类声线均完成方言腔调、气息强弱、咬字松紧三重参数标定。
2、声线试听不依赖预录片段,点击即触发实时合成音频,播放时同步显示基频波动图与共振峰分布热力图,便于创作者判断适配性。
3、支持声线混合使用,可在同一首歌中为不同段落指定不同声线,例如主歌用“青衫书生”、副歌切换为“旗袍歌女”,系统自动处理音色过渡衔接。

4、所有声线生成结果无合成痕迹残留,人声起音干净利落,尾音衰减符合真实发声物理特性,避免机械式截断或电子嗡鸣底噪。
创作流程整合性
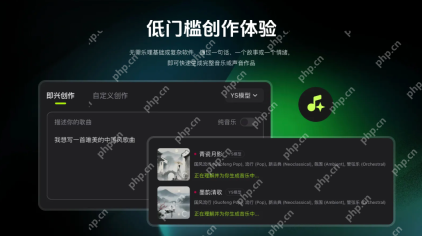
1、网页端工作台采用统一输入格式,用户提交文本提示词后,系统自动识别任务类型并分配至对应音频处理模块,无需手动切换界面或重复填写参数。
2、支持多段落连续编排,主歌、预副歌、副歌、桥段可分别设定风格与声线,各段之间自动插入过渡音效与节奏对齐逻辑,保持整体听感连贯。
3、生成过程全程可视化,时间轴上实时标注节拍位置、音高走向、动态范围变化,便于创作者进行微调与二次编辑。
4、输出文件默认包含WAV高清无损与MP3标准双版本,同时附带元数据标记,包括风格标签、声线ID、节奏BPM及生成时间戳。
交互响应效率
1、网页端基于轻量化WebAssembly架构运行核心音频引擎,不依赖插件或额外下载,主流浏览器打开即用,加载延迟低于1.2秒。
2、文本转音频平均耗时控制在8秒以内,复杂风格叠加场景下最长不超过15秒,后台持续优化模型推理路径以压缩等待时间。
3、支持断点续传式编辑,中途关闭页面后重新进入,系统自动恢复至最近一次保存节点,保留全部已配置参数与试听记录。
4、操作反馈具备多层级提示机制,从按钮悬停提示、操作成功动效到错误原因解析,全部采用中文语义化表达,避免技术术语干扰。








