





2026 年 7 月召开的计算机图形学顶会 siggraph,公布了时间检验奖(test-of-time award)。
这个奖项专门表彰十年前发表、至今仍对业界产生持续影响的论文。
而今年,香港大学计算机科学系教授 Taku Komura 与团队成员在 2016 年发表的《A Deep Learning Framework for Character Motion Synthesis and Editing》获此殊荣。
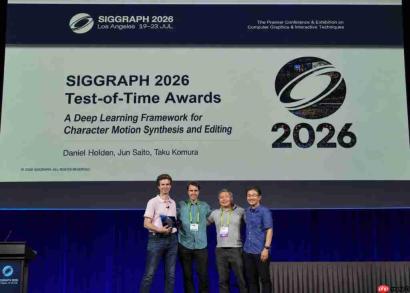
这项工作首次使用深度学习从大规模人类动作数据中自动学习人类运动的内在结构,再根据高层指令生成自然的人形角色动作。
彼时,AI 的突破还主要集中在图像领域,这项工作已经系统地把表示学习用于复杂 3D 动作的生成,让 AI 从学会如何看到学会如何动。
十年之后,这项工作的意义已经超出角色动作生成本身:机器如何从人的运动与交互中学习,理解物理世界并在其中行动,正成为物理 AI 面对的核心问题。
二十年,让身体成为一种可计算的语言
围绕这个问题,Taku Komura已经研究了二十余年。
他曾在爱丁堡大学任教多年,长期研究动作生成、物理模拟和交互技术。
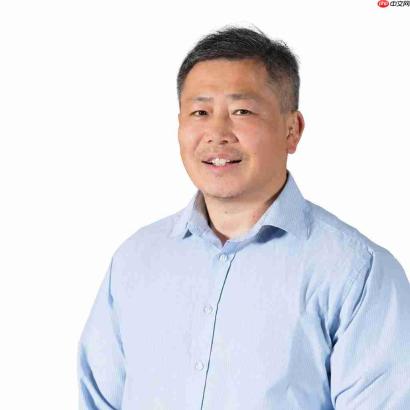
2020 年,他加入香港大学,现任计算机科学系教授。他曾任 SIGGRAPH Asia 2025 大会主席,并被 AI 2000 评为该领域最具影响力学者全球前 15。
具体而言,他希望让机器从数据中学习人类运动的结构,并进一步理解动作如何随场景、物体和任务而变化。
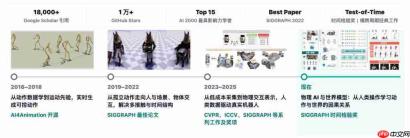
2016 年,Taku 在 SIGGRAPH 发表的获奖论文,将深度学习系统性地用于角色运动合成与编辑。
研究团队用卷积自编码器从大规模动作捕捉数据中学习一个低维的运动空间,再将行走路径等高层控制条件映射到这个空间。
模型由此可以生成和编辑动作,同时尽量保留人类运动的自然性。
这项工作的关键不在于逐帧记住训练动作,而在于学习可复用的运动表示。
用今天更熟悉的说法,它学习的是一种Human Motion Prior:哪些姿态与时间变化通常属于自然的人体运动,以及怎样在满足目标约束时仍留在这个运动空间内。
论文的引用量至今持续增长,也成为后来数据驱动动作生成研究的一项基础工作。
此后,Taku 与实验室成员继续把动作放入更复杂的场景。
2019 年的 Neural State Machine 让数字角色根据场景几何完成坐下、搬运、开门与避障;2020 年的 Local Motion Phases 则处理多接触、快速切换和全身协调等问题。
研究对象由孤立的人体动作,逐渐扩展到身体、物体和环境之间的关系。
2022 年,他与团队提出的 DeepPhase 获得 SIGGRAPH 最佳论文奖。
这项技术通过周期性自编码器从未经人工整理的动作数据中学习多维相位空间,捕捉不同身体部位随时间变化的结构。
它让系统在检索、对齐和合成复杂动作时,不再依赖人为定义的单一动作阶段;生成结果也不只在单帧姿态上 " 看起来像 ",在时间组织上同样更加连贯。
围绕这条研究线形成的 AI4Animation 开源项目已经获得 GitHub 8,000 多个 Star,是动作生成领域最具影响力的开源项目之一。
项目由团队成员持续维护,汇集了 Taku 团队长期以来在人形运动、四足运动和场景交互等方向的积累。
人类交互先验模型,为什么对具身智能重要
从 2016 年论文在十年后获得时间检验奖,Taku 的研究主线可以概括为一个完整的人类交互先验模型:
让模型先学会表示人类在真实世界的自然运动,再学习人与场景、物体和任务如何发生交互,再把真实接触、受力与环境变化纳入模型。
这条研究路线对物理 AI 的意义,正在被机器人行业验证。
真机遥操作数据采集成本高、场景窄、且动作不自然,靠它撑起通用能力并不现实;机器要学会在真实世界里做事,更可行的来源是人自己的日常操作。
但人的数据并不是采下来就能用。
要采得足够多,硬件必须便宜到可以铺开,而低成本传感器噪声大、信息缺失。
团队多年积累下来的人类交互先验模型正好补上这一环:它知道什么样的姿态和时间变化属于自然的人体运动,能把残缺的信号补齐,再约束回真实的人体运动。
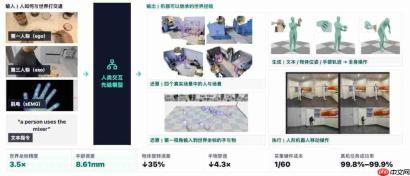
依托这套先验,团队现在用消费级设备(例如一台 iPhone 手机)就能完成采集与重建,得到人手、物体和场景在同一世界坐标系下的 3D 结果,采集成本降到过去的几十分之一,在第一人称手部重建的公开评测上误差降低 60%。
这套管线的价值不止于降低数据采集成本,更指向一个关键判断:具身智能的下一个突破口,将出现在消费级场景而非受控环境。
家庭整理、厨房操作、日常物品交互——这些场景数据量巨大、离散,边际成本极低,却因动作精细、接触关系复杂,此前始终缺乏可规模化的高质量数据来源。
Taku 团队的技术路线,让消费级设备拍摄的真实生活操作,转化并丰富物理上成立的训练数据,这意味着具身智能与世界模型未来的规模化落地,将从工厂产线走进千家万户的真实生活。
人类原生的多模态世界模型
采到数据只是第一步。
行为克隆能让机器模仿示范动作,但要在真实世界里行动,机器还必须知道一个动作会带来什么结果,以及结果背后的物理规律。
Taku 和团队正在做的,就是一个用人类原生数据训练的多模态世界模型。
现有的具身数据范式,不论是第一视角视频、UMI 还是机器人遥操数据,都只包含视觉和动作。
但同一段看起来相近的动作,背后的接触过程和操作结果可能并不相同;只依赖视觉与轨迹,模型很难区分这些差异。
Taku 团队正在推进的方向,是以人的原生操作数据为基础,补齐这些信号。
团队把采集设备做成人可以直接穿戴的形式,第一视角相机记录看到的画面,重建出的 3D 状态可以区分相机运动与真实环境变化,眼动记录人类视线的注意对象,肌电则记录发力与接触,补上人类动力学特征。
采集时人只要照常完成日常操作,即可获得时序对齐的多种模态信息。
这也改变了世界模型要预测的目标,不再只是下一帧像素,而是物理状态会怎么变:物体的 3D 状态、接触的位置、受力的大小。
对机器人真正有用的判断是 " 这样推会不会倒 "" 这个力够不够拧开 ",这些关键特征构成机器眼中的世界状态,而不是一堆像素。
以人为中心的数据,并不是终点。
人能示范的经验总有边界,机器人迟早要面对没有人做过的任务。
Taku 希望机器人把人类经验学到手之后,能在自主行动和探索中继续积累对世界的感知与行为经验,逐步具备自我探索和自主学习的能力。
今天以人类为中心的这套范式,是在为那一步打基础。
物理 AI 面对的是机器人如何适应未知环境、如何从有限交互中学习新技能。
这些问题不能只依靠公开数据集或一次性实验,需要长期采集数据,在真机上反复测试,并根据真实任务持续调整。因此,这类研究也需要与产业界深入合作。
从理解动作,到理解世界
因此在爱丁堡大学任教多年后,Taku 选择在中国香港继续自己的研究。
他很认可在中国推进这项工作的价值:中国相关领域学术活力强,产业落地场景多,为物理 AI 研究提供了丰富的实践条件。
在这样的环境中,Taku 接下来要推进的是物理 AI 更根本的目标:
让机器人形成对物理世界的内部表示,在真实交互中理解身体、动作与物理规律,并获得能够跨机器人、跨任务和跨环境迁移的行为智能。
多模态的人类原生操作数据,是他推进这一目标的重要入口。
时间从不为任何人停留,但时间会奖励那些真正理解它的人。
* 本文系量子位获授权刊载,观点仅为原作者所有。
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
点亮星标
科技前沿进展每日见






