本文介绍针对学术论文pdf中表格提取的实用方法,涵盖基于layout parser与cascadetabnet的高精度本地布局识别、fitz+ocr后处理技巧,以及amazon textract/google document ai等云服务的对比选型建议,兼顾结构保真度与批量处理效率。
本文介绍针对学术论文pdf中表格提取的实用方法,涵盖基于layout parser与cascadetabnet的高精度本地布局识别、fitz+ocr后处理技巧,以及amazon textract/google document ai等云服务的对比选型建议,兼顾结构保真度与批量处理效率。
在学术研究(如p-hacking分析)中,从大量PDF论文中准确还原表格内容与结构是关键前提。单纯依赖PyMuPDF(fitz)的find_tables()或Camelot往往失败——因其假设表格具有清晰边框或规则网格,而真实论文中的表格常为无框、合并单元格、嵌套文本或图文混排格式。因此,需构建“布局检测→区域裁剪→结构化解析”三级流水线。
1. 基于Layout Parser + CascadeTabNet的端到端本地方案
Layout Parser 是专为文档版面理解设计的开源框架,支持即插即用集成CascadeTabNet(基于YOLOv2改进的表格检测模型),不仅能精确定位表格坐标,还能输出表格类型(如table, table_caption, table_footnote),显著优于通用目标检测模型。安装与基础调用如下:
from layoutparser import Layout, load_json, load_model
import cv2

# 加载预训练CascadeTabNet模型(支持CPU/GPU)
model = load_model("lp://PubLayNet/faster_rcnn_R_50_FPN_3x/config", extra_config={"MODEL.ROI_HEADS.SCORE_THRESH_TEST": 0.7})

# 读取PDF单页图像(建议300 DPI渲染)
img = cv2.imread("page_1.png")
layout = model.detect(img)

# 筛选表格区域并提取坐标
tables = [block for block in layout if block.type == "Table"]
for table in tables:
    x1, y1, x2, y2 = table.coordinates  # 左上/右下绝对坐标
    # 后续传入fitz.Rect(x1, y1, x2, y2)进行精准裁剪
2. 结构化解析:避免纯OCR导致的行列错乱
获得精确表格区域后,切忌直接调用get_text("text")——这会丢失所有空间关系。推荐组合策略:
- ✅ 优先使用
fitz.Page.find_tables(clip=rect):对带边框/浅色背景的表格仍有效; - ✅ 对无框表格,采用
pdfplumber的extract_table():其基于字符位置聚类算法(vertical_strategy="lines"+horizontal_strategy="lines"),能自动推断行列边界; - ❌ 避免绕行OCR:除非PDF为扫描件,否则OCR会引入额外错误且无法恢复跨行单元格。
3. 云服务作为高置信度兜底方案
当本地方案召回率不足时,可将关键PDF提交至专业文档AI服务:
-
Amazon Textract:对学术PDF表格支持极佳,原生返回
Row/Cell层级JSON,含rowIndex,columnIndex,merge标识,直接映射为Pandas DataFrame; -
Google Document AI (DocAI):提供
FormParserProcessor,擅长处理带标题/脚注的复杂表格,API返回结构化字段名(如"p_value"、"sample_size"),利于后续元数据对齐。⚠️ 注意:云服务需合规评估数据隐私,建议先用脱敏样本测试精度,并启用VPC Endpoint保障传输安全。
总结与实践建议
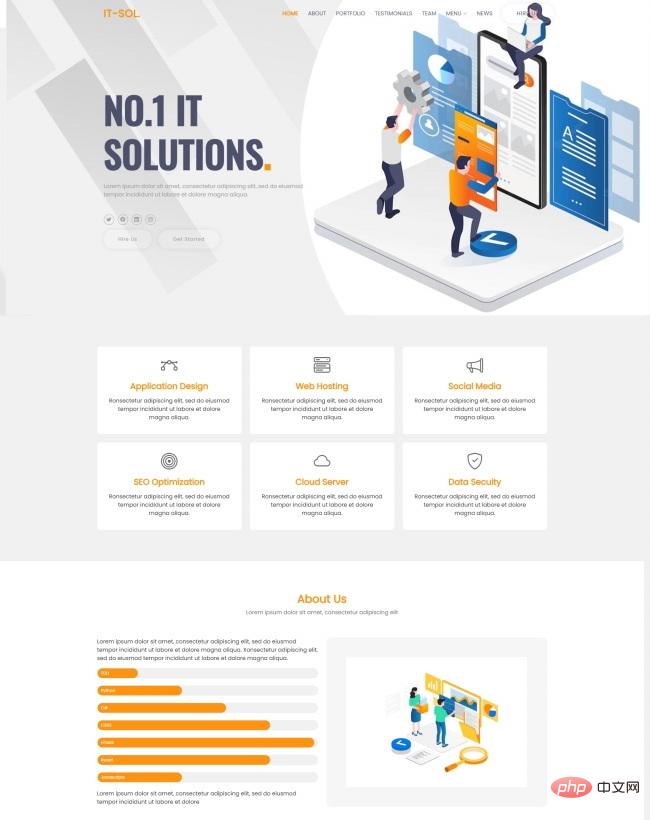
IT技术解决互联网公司网站模板是一款适合提供APP设计、网页开发、SEO优化、云服务、数据分析等服务的互联网公司宣传网站模板下载。提示:本模板调用到谷歌字体库,可能会出现页面打开比较缓慢。
- 流程优化:构建“Layout Parser粗筛 → CascadeTabNet精检 → pdfplumber结构化解析 → Textract验证关键表”的混合流水线;
-
质量控制:对每张提取表生成可视化热力图(用
cv2.rectangle叠加坐标),人工抽检10%样本; - 批量处理:将上述逻辑封装为Docker服务,通过Celery异步队列处理千级PDF,日均吞吐量可达500+篇。
最终目标不是“100%自动化”,而是以结构保真为核心,通过分层策略将人工校验成本降至最低——这正是科研级PDF表格提取的务实之道。