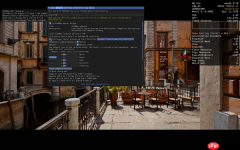
近日,开发者@iamwavecut与@mappsnet7成功将英伟达dlss 5神经渲染管线移植至苹果apple silicon平台,依托metal api实现底层对接,并结合game porting toolkit 4.0b2及reshade注入技术,有效规避了显卡厂商驱动层面的限制。
这意味着原本专为RTX 50系列张量核心优化的深度学习模型,如今可在苹果M系列芯片的GPU上完成推理与执行。
DLSS 5与前代存在根本性差异——它并非传统意义上的后处理滤镜,而是深度集成于游戏渲染流程中的神经渲染模块,需实时接入引擎原始绘图指令、运动矢量数据及帧历史缓存。开发者通过手动重构运行时逻辑,使M5 Pro能够解析原本面向CUDA架构编写的计算指令,实测画面中物体表面光照表现与接触阴影细节均有可见提升。
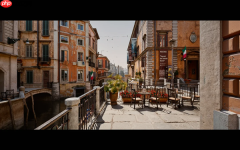

实际测试显示,在搭载16核GPU的M5 Pro版MacBook Pro上以1440p分辨率运行,平均帧率仅为2.32FPS,输入延迟高达240毫秒;而主流游戏玩家普遍接受的延迟阈值通常在20–30毫秒之间。因此,当前成果更偏向于一项验证可行性的技术演示,而非具备实用价值的游戏加速方案。
DLSS 5原生基于FP8精度设计,但M5 Pro并未配备专用FP8计算单元,只能以FP16精度进行模拟运算,导致数学计算负载翻倍;叠加多层跨架构翻译开销后,即便GPU持续满载,输出效果仍接近“幻灯片”式卡顿。此次移植的核心意义并不在于提升帧率,而在于首次证实:跨硬件架构实现神经渲染,在工程层面确有实现可能。