





b站今日正式推出全新大模型评测平台——“ai 无限竞技场”测评榜,并同步公布首期榜单排名。在由10位up主参与的真机实测中,gpt-6astra强势登顶,不仅斩获榜首位置,更以最高频次登顶荣膺“登顶次数冠军”,力压glm-5.3;前五名中,国产大模型占据三席,与国际头部模型展开正面交锋。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
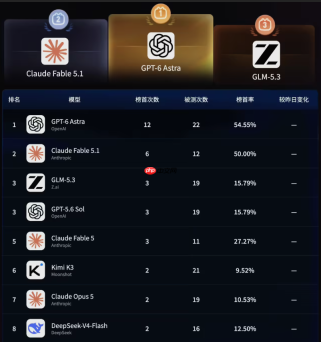
这一竞技场摒弃传统跑分式评测逻辑,转而构建一个由B站各垂类UP主驱动的真实应用广场。上百款主流大模型被置于代码编写、逻辑推理、多轮协作、知识问答等多元场景中接受检验,测评维度完全开放——不同分区的创作者可基于自身工作流、专业需求乃至创意脑洞自主设题,让模型在统一命题下直观呈现能力差异。DeepSeek、Kimi、ChatGPT、Claude、Gemini、豆包、千问、Hy、MiniMax等热门模型悉数入围,榜单实时动态更新,同时面向全站UP主长期开放报名通道。

使用 @youdotcom-oss/teams-anthropic 将 Anthropic Claude 模型(Opus、Sonnet、Haiku)添加到 Microsoft Teams.ai 应用程序中。可选集成 You.com MCP 服务器以进行网页搜索和内容提取。
B站布局该榜单的背后,是平台AI内容生态的迅猛增长。过去一年,B站AI类知识内容消费时长同比激增72%,月均观看AI相关内容的用户突破1.9亿。围绕模型发布、技术讨论、横向测评、实操教程、问题求助及社区共建的内容已形成完整闭环。当模型迭代速度远超传统评测节奏,“用真实创作者+真实任务”来定义优劣,反而更贴近用户最朴素的诉求:“哪个模型真的好用?”——B站正试图将自身深厚的社区土壤,转化为大模型走向大众应用的关键判据场。





