





[中国,上海,2026年9月17日]华为全联接大会2026于上海盛大召开,鲲鹏超节点完成重磅迭代升级,单集群最大支持4096节点互联,依托灵衢互联技术构建百tb级统一内存池,在性能更强、规模更大、安全更优三大维度持续突破,全面构筑面向agenticai时代的新型基础设施架构。
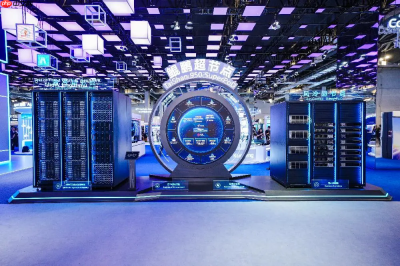
鲲鹏超节点风冷与液冷双旗舰同步发布
迈入AgenticAI新纪元,算力体系正经历深层重构——从以往以智能计算为核心,转向通用计算与智能计算深度融合的协同范式。在AgenticAI工作流中,CPU承担着任务编排调度、长期记忆管理、沙箱环境隔离等关键职能,由此产生的新型计算负载对现有架构提出更高要求。为此,鲲鹏聚焦底层根技术突破,以“芯-硬-软”全栈协同为路径,打造具备领先性、开放性与内生安全性的智能体基础平台。
2025年,我们率先推出全球首个通用计算超节点,具备内存统一寻址、超高带宽、超低延迟三大核心能力。今年,鲲鹏超节点迎来全面进化:通过灵衢互联设备实现双层CLOS拓扑组网,节点扩展能力跃升至4096;借助灵衢提供的超大带宽能力,可构建百TB级全内存资源池,支撑八大典型场景实现性能跨越式提升。
目前,鲲鹏超节点已在生成式广告推荐、金融证券高频交易、AI Agent沙箱等实际业务中规模化落地。在生成式推荐场景中,依托灵衢加速RPC通信并构建百TB级全内存KVCache,端到端在线推荐时延下降15%;在证券低时延场景中,采用内存语义通信替代传统网络传输,整体时延降低达50%。
在AgenticAI推理环节,Prefill阶段面临序列持续拉长带来的KV Cache容量瓶颈及远端存储带宽受限问题。鲲鹏超节点利用灵衢高带宽互联构建超大规模KVCache缓存池,使KVC命中率高达99%,并结合自研KAE引擎实现KV Cache高压缩算法,物理存储空间节省25%。进入Decode阶段后,随着序列长度增长(如≥256K),单卡片上内存需求突破300GB,严重制约NPU并发效率。鲲鹏超节点通过灵衢ScaleUp网络提供百TB级弹性内存池,接入后NPU单卡吞吐在256K与1M序列长度下分别提升2倍和2.6倍,且序列越长,性能增益越明显。
针对Agent沙箱场景中高并发启动与高密度部署的双重挑战:强化学习训练需支持10万个沙箱秒级拉起;高密超分场景则受限于核存比失衡导致的内存瓶颈。鲲鹏超节点沙箱引擎集成镜像预加载与RemoteFork机制,实现10秒极速启动;叠加超大内存池与沙箱暂停/恢复能力,沙箱部署密度提升25%。当Agent深度融入核心生产系统,安全性成为不可逾越的红线。鲲鹏围绕处理器、操作系统、应用层构建三层内生安全体系:鲲鹏处理器内置可信安全根,原生支持国密算法,对Agent异常行为识别与拦截准确率高达99%。
展望未来,鲲鹏将正式发布新一代液冷超节点。该产品同样支持最大4096节点扩展,并可形成高达256TB的统一内存池,显著释放Agent运行效能。在Agent沙箱场景中,十万级沙箱启动速度相较传统服务器方案提速30倍,沙箱密度进一步提升25%;在向量检索场景中,面对百亿规模、千维特征的复杂向量搜索任务,检索效率较传统服务器实现翻倍提升。
AgenticAI浪潮席卷千行百业,CPU正重新站上AI时代的核心舞台。鲲鹏始终坚守“以架构驱动算力进化”的理念,持续打磨AI时代先进算力底座,用创新架构开辟全新可能,为全球产业智能化升级提供坚实支撑与多元选择。


