





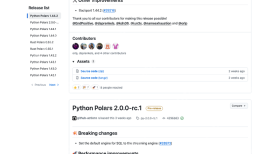
polars 官方 github 发布页的更新记录显示,python 版 polars 1.43.2 给 `scan_csv` 新增了 `infer_schema_files` 参数,同时还带来了 arrowstreamexportable 相关的 futurewarning 调整、lazyframes 字节序列化支持、`sqlcontext.execute()` 释放 gil、sortedness 传播等多项增强。对于需要读取大量 csv 文件的项目来说,用来推断 schema 的文件范围,直接决定了启动耗时、推断准确率,以及多文件任务的结果一致性。
来源:Polars 官方 GitHub Releases
1.43.2 版本还同步列出了一批弃用项,包括 Categorical 转整数 dtype 的 cast 操作、未设置 `plan_stage` 参数就调用 `show_graph()` 等场景。性能优化部分,官方提到已经把 `len()` 操作下推到 concat/union 的输入节点。这些改动看起来分散,实际上都是 Polars 在懒引擎、SQL 支持、执行图可解释性方向上的持续打磨。
来源:Polars Cloud 官方文档
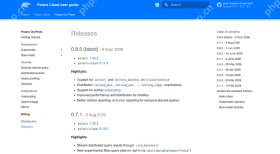
前一个 1.43.1 版本,修复了 scan_delta/scan_iceberg 自连接引发的程序 panic、SQL 中 `NOT IN` 和 NULL 值交互异常、join schema 位置检查逻辑错误、窗口键谓词下推失效等问题;同期推出的 Polars Cloud 0.7.1,也完成了 `sink_batches()`、Miso 查询优化器、分布式 `pl.collect_all()` 以及 HDFS/Iceberg 实验性支持的迭代。如果你现在正在使用 1.43 系列版本,升级时要把 CSV 多文件扫描、SQL 查询、Delta/Iceberg 读写这几类场景放进重点测试清单。
从 Polars 历年的更新记录能看出来,这个项目迭代速度很快,大部分改动都集中在懒引擎、SQL、云服务、Iceberg、Parquet 和执行计划层。对数据团队来说,版本升级验证不能只跑几个简单的 DataFrame 示例就完事,必须覆盖真实业务查询、各类文件扫描、分组聚合、表关联、SQLContext、云存储读写和 streaming 执行全路径,才能发现引擎或优化器逻辑变动带来的隐性差异。

现在官方文档已经把 LazyFrame、SQL、API 参考和 Cloud/本地部署的发行说明分开维护,足以说明 Polars 早就不是单纯的单机 DataFrame 库。大家选版本的时候要注意区分 Python 版 Polars、Rust 版 Polars、Polars Cloud 和预发布版本,生产环境优先选稳定补丁版,2.0.0-rc.1 这类预发布版本只用来提前做兼容性演练即可。
由于 Polars 同一个正式版本往往同时包含弃用项、性能优化、功能增强和 bug 修复,升级过程里一定要完整保留所有 warning 输出。官方发布页里的 PR 编号也能帮团队快速定位具体改动的来源,如果升级后发现查询结果、执行计划或者内存峰值和之前不一样,直接去对应版本的更新条目和 API 文档里核对原因就行。
这也提醒大家,平时最好留存好真实业务的查询样例,升级后跑一遍就能快速复核执行结果是否正常。
信源说明:本文依据 Polars 官方 GitHub Releases 里的 Python Polars 1.43.2、1.43.1 更新日志,以及 Polars Cloud 官方发布页面整理撰写;所有实验性功能和弃用规则请以当前的最新官方文档为准。
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!






