从numpy官方github的releases页面能看到,2.5.3是2.5.x分支的线上补丁版本,整个发布说明的核心都是修复2.5.2推出后发现的各类bug。其中官方专门点名了stringdtype相关的修复:之前把定宽字节字符串数组转成stringdtype的时候,如果输入内容不是合法的utf-8编码,现在会直接抛出typeerror报错。这个改动相当于提前把坏数据拦下来,避免无效字节流到后续的字符串操作环节,触发更难排查的隐性问题。
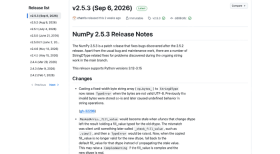
来源:NumPy 官方 GitHub Releases
这个调整思路,和2.5.0版本就开始推进的字符串接口清理方向是一脉相承的。2.5.0的发布说明里就明确把 `numpy.char.chararray`、`numpy.char.[as]array` 这类字符串相关接口标为弃用,官方推荐大家直接用带字符串或字节dtype的ndarray来处理。对那些还在把NumPy字符串数组当轻量文本容器用的项目来说,2.5.x版本已经把信号摆得很明白了:旧的chararray处理路径正在逐步下线,后续所有调整都会围绕StringDType和语义更明确的dtype规范来展开。
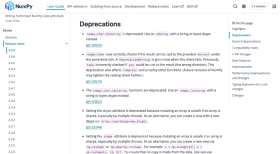
来源:NumPy 官方发布说明
除此之外2.5.3还修复了一个问题:ufunc操作改变dtype之后,MaskedArray的 `_fill_value` 可能还是旧值。官方提到,之前版本里这种不匹配的fill_value,往往要等到调用 `.view()` 或者 `_check_fill_value` 的时候才会抛出TypeError报错,延迟很高。新版本里如果复制过来的fill_value不符合新的dtype要求,会自动回退到对应类型的默认值。这个修复对大量用掩码数组处理缺失值的科研脚本特别友好,能减少延迟报错和隐式的状态残留问题。
对项目维护者来说,这类版本更新还要同步检查整个依赖树的兼容性。NumPy是大量科学计算、机器学习、数据处理工具的底层依赖,某个接口的弃用不一定会在你的应用层直接报错,很可能通过pandas、SciPy、scikit-learn或者自研的C扩展间接抛异常。最稳妥的操作是先在依赖锁定的隔离环境里升级版本,跑一遍全量流程看有没有DeprecationWarning警告,核对构建日志和二进制包的来源,确认没问题之后再同步到生产镜像里。
官方没有强制要求所有项目立刻升级到这个最新补丁版,但2.5.x整个系列已经给出了非常清晰的迁移方向:支持的Python版本窗口持续上移,旧的构建路径逐步下线,字符串dtype和数组的行为校验会越来越严格。只要你的项目涉及长期归档数据、旧dtype兼容逻辑,或者需要自己编译多平台二进制包,最好把这些改动提前列进后续升级清单,别等大版本迭代的时候再集中一次性处理,到时候堆的改动太多反而容易出问题。
信源说明:本文内容全部整理自NumPy官方GitHub Releases的2.5.3发布公告,以及NumPy 2.5.0官方发布说明里的字符串相关弃用规则;涉及数据清洗和扩展类型的项目,升级前一定要跑通自己的全量测试用例。