





这两年ai的热度,无需多言,大家都有切身体会。从gpt-3引爆全网,到openclaw“龙虾”成功将语言模型落地为真实生产力,ai早已跳脱出“科技圈概念”或“发布会ppt”的刻板印象,真正走进千家万户——点开即用、无需配置,已成为日常办公与娱乐的标配。
无论是头部科技公司,还是独立开发者、内容创作者,都在积极拥抱AI:写方案、润色文案、调试代码、生成短视频脚本、智能客服问答……AI已深度嵌入工作流与生活场景,成为不可或缺的数字助手。
多数用户选择云端AI服务——轻量对话随手可得,零门槛上手;进阶用户则通过官方API接入,灵活集成到自有系统中。但有两类人群更倾向本地部署大模型:一类是热衷DIY的技术爱好者,另一类则是对数据安全有硬性要求的中小专业团队。
对个人极客而言,或是顾虑云服务持续付费成本过高,或是担忧敏感文档上传存在隐私泄露风险,干脆自建本地推理环境——图的就是开源、可控、无限制。
而像律所、设计工作室、硬件研发团队等机构,则把数据不出域视为铁律。客户合同、源码资产、未公开专利文档,任何外传都可能带来不可逆的风险,本地化部署成了唯一可行路径。
然而,超大规模模型训练依赖顶级算力集群与PB级存储,这对普通用户和小微团队而言遥不可及。因此,过去本地跑大模型往往意味着性能打折、响应迟缓、上下文受限,体验远逊于云端旗舰模型。
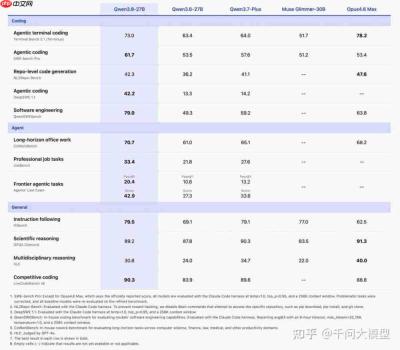
好在这一门槛正快速下探。就在上月,Qwen(通义千问)发布3.8版本,其中蒸馏优化后的Qwen3.8-27B表现亮眼:在LiveCodeBenchv6编程能力测试中斩获90.3分,稳居主流模型第一梯队;在衡量AI智能体综合能力的SWE-benchPro与OSWorld-Verified两项权威 benchmark 中,甚至超越Claude Opus 4.6。
更关键的是部署友好度大幅提升:采用Q3_K_M量化后,仅需16GB显存即可流畅运行。以RTX 4070 Ti Super为例,实测推理速度约10 token/s,应付日常对话、文案生成、代码辅助完全游刃有余。
但要注意:本地部署不只拼显卡,内存同样至关重要。使用vLLM、llama.cpp等主流推理框架时,即便模型权重全部加载进显存,系统仍需在内存中预留缓冲区,用于存放KV Cache、历史上下文、中间计算结果等。尤其在多轮深度对话、万字长文档解析、批量代码生成等高负载任务中,内存压力尤为突出。
换言之,一块高性能显卡只是入场券,而要让大模型真正“满血发挥”,一套高带宽、低延迟、大容量的内存系统,才是稳定运行的底层支柱。
开箱
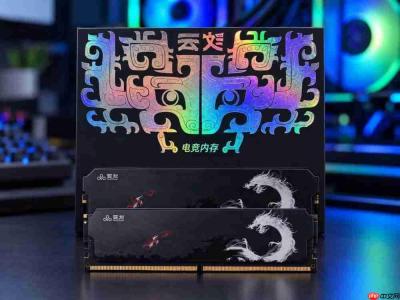
本次我们选用云彣(UniWhen®)旗下绫龙DDR5 6000 C36 48GB(24GB×2)双通道套条,与当前主流32GB配置同平台对比,实测其在本地AI任务中的实际表现差异。
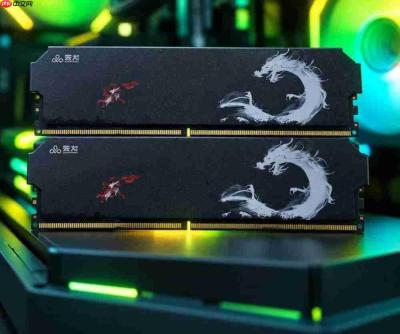
先看产品本体:绫龙DDR5延续品牌标志性的水墨国风设计语言,以经典IP《哪吒闹海》为灵感,将少年英雄的果敢气魄融入产品肌理。墨焰黑主色调沉稳内敛,搭配细腻纹理,整套内存不仅性能扎实,更赋予主机东方美学格调,我个人非常欣赏这种文化表达。
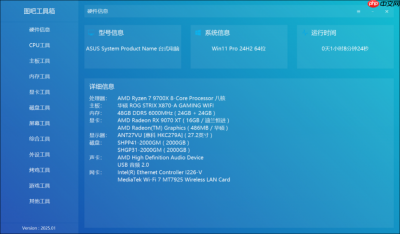
装机平台如图所示,本次测试聚焦AI核心能力,其他性能指标不做冗余展开。
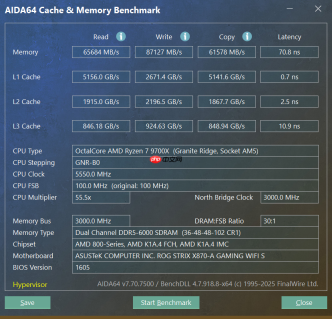
借助AIDA64进行内存带宽测试:除容量外,读写吞吐能力直接影响模型加载速度、上下文交换效率乃至整体推理响应——更高的内存带宽,意味着更少等待、更顺滑的AI交互体验。
接下来进入重头戏:AI实战对比。我们在统一硬件平台、同一模型(Qwen3.8-27B)、相同量化精度(Q3_K_M)下,分别测试32GB与48GB内存配置在三大典型场景下的表现:长上下文对话、长文档理解、复杂代码生成。
32GB双通道内存:入门够用,高负载捉襟见肘

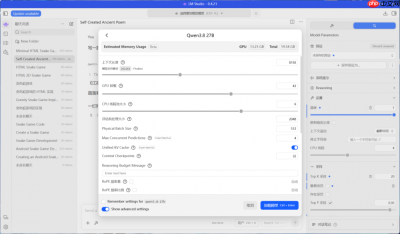
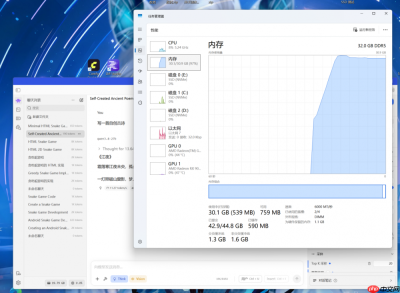
当前主流32GB配置,在轻量AI任务中表现尚可。但一旦开启8K上下文长度,系统内存压力骤增:模型加载完成后,物理内存占用迅速逼近极限,剩余可用空间不足1GB;已提交内存高达44.8GB,系统被迫频繁调用虚拟内存,此时再执行复杂任务极易触发卡顿、延迟甚至崩溃。
当然,8K上下文足以支撑基础闲聊与短文本处理。但若后台常驻浏览器、IDE、设计软件等应用,或需AI连续完成分析→构思→编码→调试的完整闭环,32GB就显得力不从心了。
以“编写贪吃蛇游戏”任务为例,在8K上下文下,模型尚未进入编码阶段,思考链已逼近上限,难以承载深度逻辑推演与多步协同,重度AI玩法自然受限。
48GB大容量双通道内存:释放本地AI全部潜能
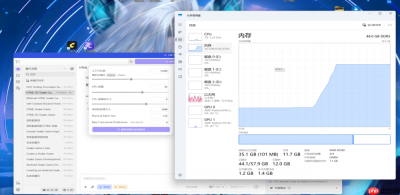
升级至绫龙48GB套条后,最直观的变化是上下文长度轻松翻倍——16K超长上下文可稳定启用。实测内存占用约35GB,仍有充足余量应对突发需求。
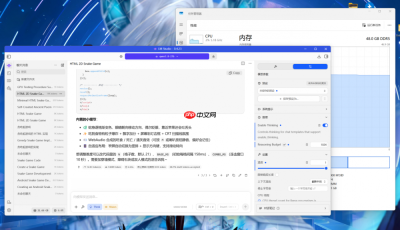
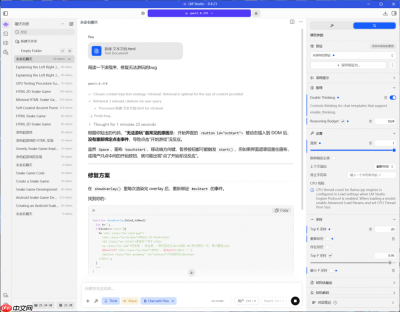
同样执行“贪吃蛇开发”任务,在16K上下文支持下,模型可在单次会话中完成需求理解、架构设计、代码编写、BUG定位与交互优化全流程,并支持连续追问与即时修改,体验连贯自然,彻底告别碎片化交互。
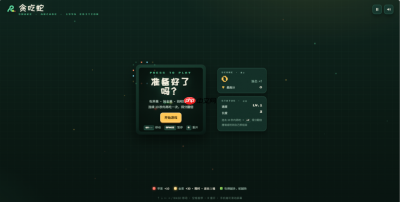
(由Qwen3.8-27B生成的贪吃蛇网页游戏)
在常规高频场景中,无论是连续十几轮语义连贯的对话,还是一次性解析PDF报告、技术白皮书等万字长文,均全程流畅无卡顿、无闪退、无降速,稳定性显著提升。
总结
回到起点:当前消费级显卡显存天花板仍停留在24GB,想要本地原生运行百亿级参数模型,虽非不可能,但需投入专业计算卡,动辄上万元的成本对绝大多数用户并不友好。
对本地AI而言,显卡是必要条件,而内存则是决定体验上限的关键变量。32GB能满足尝鲜、轻办公等基础需求;但若你希望长期驻留模型、高效处理长文档、深度参与代码开发或创意生产,那么48GB大容量内存的价值便无可替代——它带来了更长的上下文记忆、更强的多任务并行能力,也让本地AI真正从“能用”跃升为“好用”“爱用”的生产力引擎。
云彣(UniWhen)绫龙DDR5 6000 C36 48GB套条在此定位下表现稳健出色,兼容性强、发热控制优秀、性能释放充分,精准匹配本地满血运行大模型的核心诉求。如果你正为AI卡顿、上下文不足、多任务崩溃而困扰,这套内存无疑是值得优先考虑的升级选项之一。


