





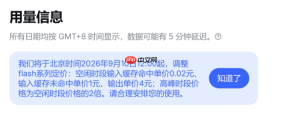
根据 deepseek 开放平台发布的通知,官方将于北京时间 2026 年 9 月 10 日 12:00 起正式启用新版定价策略,对 flash 系列模型费用进行优化调整。
调整后价格如下:空闲时段——输入缓存命中为每百万 Token 0.02 元,输入缓存未命中为每百万 Token 1 元,输出为每百万 Token 4 元;高峰时段所有计费项均按空闲时段价格的两倍执行。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
三档计费标准全面下调,缓存命中成本降幅高达 60%
当前 Flash 系列涵盖 deepseek-v4-flash 与 deepseek-v4-flash-vision-exp 两款模型,二者同步适用本次调价政策。

飞书文档「剥洋葱式」分层优化工具。将长文档重组成五层结构:第一层50字快速判断 → 第二层核心能力清单 → 第三层自测题 → 第四层目录摘要 → 第五层深度内容。专为飞书 wiki、飞书文档、飞书多维表格说明文档等场景设计,让 AI 在检索时先快速判断匹配度,不匹配直接退出,最高节省 98% 的无效 token 消耗。触发词:「文档太长」「省token」「文档结构优化」「飞书文档优化」「分层」。
详细变动情况为:输入(缓存命中)价格在空闲时段由 0.05 元下调至 0.02 元,高峰时段由 0.10 元降至 0.04 元,整体降幅达 60%;输入(缓存未命中)价格空闲时段从 1.5 元降至 1 元,高峰时段由 3.0 元调整为 2 元,降幅为 33.33%;输出价格空闲时段由 4.5 元下调至 4 元,高峰时段则由 9.0 元降至 8 元,降幅为 11.11%。
以输出场景为例,用户在空闲时段调用每百万 Token 输出,仅需支付 4 元。此次调价是 DeepSeek 在近期完成 API 整体价格上浮后,针对 Flash 系列模型推出的专项优化举措。



