





大模型真的存在难以逾越的技术壁垒吗?不久前从openai加盟腾讯的姚顺雨曾坦率表示:“做大模型其实并没有什么秘密。”起初外界多将其视为一句调侃,但随着腾讯混元4(hy4preview)近期正式亮相,这句话的分量被彻底验证。
在智谱、月之暗面、DeepSeek、千问等头部玩家激烈竞逐的格局下,腾讯仅用四个月便完成大语言模型与多模态团队的深度整合,并推出参数规模达770B、支持百万级上下文长度的混元4。深入剖析其技术架构可见,所谓“独家绝技”,早已在开源协作与顶尖人才高频流动的双重作用下被充分拆解与复用。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
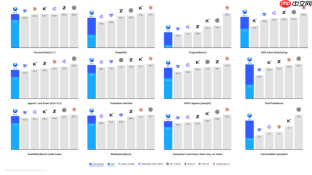
从基础结构看,混元4瞄准700B量级这一国内主流中大规模区间,直接对标智谱GLM-5(744B)已验证成熟的工程范式。其主干网络设定为隐藏层维度6144、共78层、每层配备64个注意力头——这一组合体现了对Transformer在深度、宽度与注意力并行性三者间平衡的共识性选择。对亟需快速突破的腾讯而言,沿用已被反复验证的架构底座,显著规避了试错成本。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
在核心注意力机制的设计上,混元4展现出对开源成果的高效集成能力。其主干模块融合了DeepSeek V3.2中开源的稀疏注意力机制(DSA),借助轻量级索引器在超长文本中动态筛选Top-K Token,大幅减少冗余计算;同时引入智谱IndexCache中提出的跨层索引复用策略,使相邻Transformer层可共享前序层生成的索引结果,最高降低75%索引器开销,端到端推理效率明显提升。而在残差连接优化方面,混元4并未采用复杂的mHC结构,转而采纳微软研究员谢天曾在社交平台公开探讨的恒等超连接(iHC)方案。
技术演进的背后,是高端人才的实质性迁移。清华姚班出身、曾任智谱GLM-5新架构及DSA技术负责人白雨石,数月前已正式加入腾讯混元团队,并作为核心作者出现在混元长上下文稀疏注意力相关论文中。正是这类顶尖研究者的跨机构流动,推动着原本沉淀于单一体系内的隐性工程经验,完成真实、高效的物理转移。
当下,任何可通过论文、代码与实验数据具象呈现的技术优势,其窗口期正以前所未有的速度收窄。从顶会发布到开源托管,再到社区技术帖的即时讨论,前沿模型架构的传播路径已然高度扁平化。大模型领域的护城河,正在被蓬勃发展的开源生态与加速流转的顶尖人才持续消解。


