





nginx 中 backup 服务器仅在所有非 backup 节点被标记为不可用时启用,需配合健康探测(max_fails/fail_timeout)、重试策略(proxy_next_upstream)及合理超时设置才能生效。
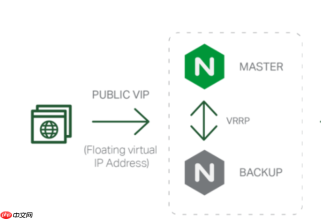
在 Nginx 中用 backup 关键字配置热备服务器,本质是让某台后端节点只在所有主节点全部失效时才启用——它不参与日常流量分发,专用于故障兜底。这不是“自动切换VIP”那种基础设施级高可用,而是服务层的容错设计,必须配合健康探测和重试策略才能真正生效。
backup 节点的基本写法与行为特点
在 upstream 块中为某台服务器加上 backup 参数即可:
upstream app_backend {
    server 192.168.1.10:8000;   # 主节点,正常轮询
    server 192.168.1.11:8000;   # 主节点,正常轮询
    server 192.168.1.12:8000 backup;  # 热备节点,平时不接收任何请求
}
- backup 节点完全不参与
round-robin、least_conn或权重调度 - 只有当所有非 backup 节点都被 Nginx 标记为“不可用”时,它才会被选中处理请求
- 它本身也需能独立承载全量流量,否则切换后可能立即过载
必须搭配健康探测机制,否则 backup 不会触发
Nginx 不主动探活,而是靠请求失败来动态标记节点状态。需在 upstream 和 location 中协同配置:

- 在 upstream 中设置:
max_fails=3 fail_timeout=30s,表示连续 3 次失败后,30 秒内不再向该节点发请求 - 在 location 中启用重试:
proxy_next_upstream error timeout http_502 http_503 http_504,让这些错误触发换节点 - 注意:默认只把连接拒绝(connection refused)和超时(timeout)算作失败;HTTP 错误码需显式列出才会计入
防止卡死,收紧代理超时参数
若主节点响应极慢但未断连,Nginx 可能长期等待而不转向 backup。应限制各阶段耗时:
-
proxy_connect_timeout 3s:建立 TCP 连接最多等 3 秒 -
proxy_send_timeout 5s:发送完整请求体最多 5 秒 -
proxy_read_timeout 10s:收到响应头前最多等 10 秒(不是整个响应) - 可加
proxy_next_upstream_tries 3,限制最多尝试 3 个后端(含重试)
上线前务必验证是否真能切换
不能只看配置语法正确,要实测故障路径:
- 手动停掉一台主服务器(如
systemctl stop nginx或关机),观察 access log 是否开始出现 backup 节点 IP 的访问记录 - 检查 Nginx error log,确认有类似
upstream server temporarily disabled的日志,说明节点已被摘除 - 用 curl 持续请求,验证在主节点宕机后,服务仍可响应且无明显中断





