





通过在Nginx日志中记录$request_time和$upstream_response_time,可精准定位接口慢在Nginx层、后端或网络环节;配合awk筛选、百分位分析及三类耗时模式比对,无需额外监控即可高效诊断真实慢请求。
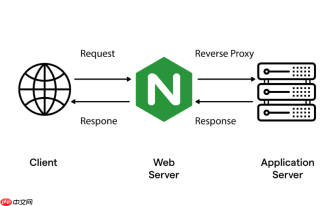
直接在 Nginx 访问日志中记录 $request_time 和 $upstream_response_time,就能定位哪个接口慢、慢在哪一环——不用加监控、不靠猜。
确保日志格式包含关键时间字段
默认日志不记录耗时,必须在 nginx.conf 的 http 块里明确定义 log_format:
log_format timing '$remote_addr - [$time_local] "$request" $status $body_bytes_sent "$http_referer" "$http_user_agent" $request_time $upstream_response_time $upstream_addr';
access_log /var/log/nginx/access.log timing;
- $request_time:客户端感知的总耗时(秒,毫秒精度),从收到第一个字节到发完最后一个字节
-
$upstream_response_time:Nginx 与后端通信的真实耗时,多个 upstream 会以逗号分隔(如
0.002,1.247) - $upstream_addr:对应每次转发的目标地址,和 upstream_response_time 严格顺序一致,便于逐次排查
配置后执行 nginx -s reload 生效。
按接口路径精准筛选并提取耗时
假设要分析 /api/order/list 接口,用 awk 快速提取其所有请求耗时值:

awk '$7 ~ /^\/api\/order\/list($|\?)/ {print $NF}' /var/log/nginx/access.log
- $7 是默认格式中
"$request"字段的位置;若你自定义了 log_format,先用head -1 access.log确认$request_uri和$request_time各在第几列 - 正则
($|\?)覆盖带参数和不带参数的请求,避免漏掉 - 输出纯数字便于后续统计,例如喂给
sort、datamash或简单脚本
识别三类典型瓶颈模式
看两个时间字段的大小关系和分布,比平均值更有诊断价值:
- $request_time 明显大于 $upstream_response_time(差值 >200ms):瓶颈在 Nginx 层或客户端侧。常见原因包括 SSL 握手慢、大 body 解析卡顿、gzip 压缩 CPU 高、proxy_buffering 关闭导致流式阻塞、或客户端弱网上传慢
- 两者接近且同时偏高(如都 ≈1.5s):问题基本出在后端。重点查该接口对应的数据库慢查询、同步逻辑阻塞、线程池打满、GC 暂停或连接池耗尽
- $upstream_response_time 为 "-" 或极小(如 0.001s),但状态码是 502/504:upstream 连接失败,没走到业务逻辑。检查 DNS 解析、防火墙策略、后端进程存活、或 upstream keepalive 配置是否合理
聚焦真实慢请求,避开平均值陷阱
大量快请求会把平均值拉低,掩盖长尾问题。应关注百分位数:
- 提取该接口所有
$request_time,排序后取 P95(前 5% 最慢):
awk '$7 ~ /^\/api\/order\/list($|\?)/ {print $NF}' access.log | sort -n | tail -n +$(($(wc -l - 对比基线(如 7 天前同一小时段):P95 上升超 30% 且持续数小时,就是明确的性能退化信号
- 优先筛选
status=200 且 $request_time > 2s的请求,排除错误干扰,专注“成功但很慢”的场景






