





关键不是追求绝对均匀,而是让负载分布与业务真实压力特征对齐:长连接服务必须用least_conn,会话场景慎用ip_hash而改用一致性哈希,异构集群需基于实测qps设weight,主动健康检查与被动检查并行,禁用ip_hash与weight共存等干扰配置。
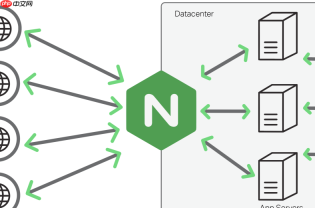
不能“彻底消除”热点,但可以大幅收敛、可控规避。关键不是追求绝对均匀,而是让负载分布与业务真实压力特征对齐——算法选错,越调越偏。
按业务连接模型选算法,不套默认配置
轮询(round-robin)在多数生产环境是起点,不是终点。它只看请求次序,不看连接状态、响应耗时或后端真实负载:
- 长连接服务(WebSocket、gRPC、HTTP/2网关):必须用 least_conn。它统计的是当前活跃连接数,而非请求数,能真实反映节点吞吐压力。轮询下,一个已建立的长连接可能复用数百次请求,全部打向同一台后端,导致连接堆积、FD 耗尽、首字节延迟飙升。
- 含会话状态但又怕 IP 集中(如企业内网/NAT 环境):禁用 ip_hash,改用 hash $http_x_forwarded_for consistent 或 hash $cookie_session_id。一致性哈希在增减节点时仅重散列 1/N 的连接,避免扩缩容引发大面积会话中断。
- 异构集群(新旧机器混部、云上不同规格实例):启用 weight,但权重值要基于实测 QPS 或 CPU 平均负载反推,例如新机处理能力是旧机的 2.3 倍,weight 就设为 23,旧机设为 10,而非拍脑袋填 5 和 2。
让健康检查真正驱动流量调度
被动检查(靠请求失败触发)在高并发或长连接场景下完全失效——一个卡死的后端可能持续承接新连接数分钟,直到超时堆满。

- 主动探测必须开启:在 upstream 中配置 health_check interval=5s fails=3 passes=2 match=status_2xx timeout=3s,且 health_check 路径直连后端内网地址,不走公网、不绕 LB、不透传额外 header。
- tcp_check 用于数据库代理类后端:比 HTTP 更轻量,避免健康接口本身成为瓶颈。
- max_fails/fail_timeout 要放宽:设为 max_fails=3 fail_timeout=30s,防止瞬时网络抖动误踢节点;同时确保主动检查与被动检查并行不互斥,形成双保险。
关闭算法干扰项,守住核心逻辑
很多“不均”其实来自配置冲突,而非算法本身:
- ip_hash 和 weight 绝对不能共存:Nginx 会直接忽略 weight,所有哈希结果固定绑定某台 server,权重形同虚设。
-
proxy_pass 结尾不要加 /:写成
proxy_pass http://backend/;会强制重写 URI,导致后端收到错误路径,可能返回 404 或触发非预期逻辑,间接造成部分节点请求失败率升高、被频繁踢出。 - 长连接场景下,upstream keepalive 数值要合理:设为 32~64(约为单 worker 并发峰值的 1/3),过大会撑爆后端连接池,过小则频繁建连,抵消长连接优势。
用监控闭环验证算法有效性
光看 Nginx 日志或连接数不够,需关联后端真实指标:
- 采集每个 upstream server 的 active, max_conns, downtime, rise, fall 实时状态(通过 stub_status 或 nginx-plus API)。
- 对比后端节点的 平均连接数、P95 响应时间、线程池 busy ratio,如果 least_conn 下某台 active 连接始终高出 3 倍,大概率是后端自身存在慢查询或锁竞争,不是 Nginx 分配问题。
- 开启 log_format upstream_log … $upstream_addr $upstream_response_time,用日志分析实际分发路径与耗时分布,识别是否出现“某 IP 段全打向同一节点”等隐性倾斜。






